Além da pesquisa isolada, um modelo para ler o segundo turno de 2026
outubro 22, 2026 § Deixe um comentário
Última atualização: 22 de outubro de 2026, com dados até a pesquisa PoderData/Aya divulgada neste dia.
Este post será atualizado a cada nova pesquisa relevante até sábado, 24 de outubro, véspera do segundo turno. Os números e gráficos abaixo sempre refletem a versão mais recente do modelo.
Nas últimas semanas, cada nova pesquisa de segundo turno virou manchete e, quase sempre, sentença. Se um instituto mostra 51 a 49, a leitura é de vantagem, se outro mostra 50 a 50, a disputa “virou”. Quando um terceiro inverte a ordem, é “reviravolta”. O problema é que boa parte dessas oscilações não diz nada sobre o eleitor, apenas refletem o funcionamento das próprias pesquisas.
Toda pesquisa é uma estimativa feita a partir de uma amostra e, por isso, carrega uma margem de erro. Em uma disputa decidida por um ou dois pontos, essa margem é do tamanho da própria diferença entre os candidatos. Acompanhar a sequência de pesquisas de um mesmo instituto ajuda, mas também engana (uma variação de um ponto pode ser só ruído amostral travestido de tendência). Além disso, cada instituto tem seu método, alguns entrevistam pessoalmente, outros por telefone ou pela internet. Da mesma forma, uns ponderam a amostra de um jeito, outros de outra, divulgam votos totais ou votos válidos. Comparar duas pesquisas diretamente é como comparar duas réguas diferentes.
Há ainda um problema mais sutil, uma pesquisa de segundo turno pergunta ao eleitor em quem ele pretende votar. Acontece que já temos uma informação muito mais sólida do que qualquer intenção, sabemos como esse mesmo eleitorado efetivamente votou há poucas semanas, no primeiro turno. O que se ganha ao juntar as peças?
Quando agregamos as pesquisas recentes, dando mais peso às mais novas e às mais precisas, os erros aleatórios de cada uma tendem a se compensar. Nenhum instituto sozinho define o resultado, assim como um ponto fora da curva não muda o retrato inteiro.
O modelo que apresento aqui leva em consideração uma série de fatores: várias pesquisas, em vez de uma (um agregador); o primeiro turno como âncora (o resultado das urnas não é estimativa, ele diz quanto cada candidato já tem e, principalmente, quantos votos estão em disputa, afinal alguns candidatos ficaram pelo caminho); para onde vão esses votos (várias pesquisas perguntam a quem votou nos candidatos derrotados em quem votará agora, esses cruzamentos permitem estimar a migração de votos com base em dados); quem não votou no primeiro turno (parte de quem se absteve ou votou branco/nulo pode voltar às urnas e esse grupo não pensa necessariamente como a média); a tendência recente (o modelo observa a direção das últimas pesquisas, mas com peso pequeno uma vez que são justamente o componente mais sujeito a ruído); e a incerteza explícita (em vez de um número seco, o modelo produz uma estimativa central acompanhada de faixas de incerteza, obtidas por simulação).
E se as pesquisas errarem todas na mesma direção? As margens de erro divulgadas tratam apenas do erro aleatório de cada amostra, elas não cobrem a possibilidade de que todos os institutos errem juntos, por exemplo por terem dificuldade em alcançar determinado perfil de eleitor. Essa preocupação foi levantada publicamente por especialistas do setor. O modelo aqui apresentado não assume que ela seja verdadeira, mas testa quanto o resultado mudaria se fosse. Uma imagem ajuda, pense em várias testemunhas de um mesmo acontecimento, cada uma posicionada em um ângulo diferente. Nenhuma viu tudo e cada uma tem seus vieses. Ouvir só uma delas é arriscado, mas ouvir todas, saber de onde cada uma olhou e cruzar o relato com as evidências físicas da cena dá um quadro muito mais confiável.
O que este modelo é e o que não é
Vale ser direto sobre os limites desde o início. O modelo não calcula a probabilidade de vitória de nenhum candidato e não é uma previsão do resultado. Ele produz uma estimativa central da divisão dos votos válidos, o que em inglês se costuma chamar de nowcast, ou seja, um retrato de onde a evidência disponível aponta hoje e não de onde a eleição estará no domingo.
Os pesos atribuídos a cada componente são escolhas de modelagem, explicitadas e justificadas ao longo do texto, não são coeficientes estimados estatisticamente a partir de eleições passadas. Outras escolhas razoáveis produziriam números ligeiramente diferentes, a vantagem de explicitá-las é que qualquer pessoa pode discordar de uma premissa específica e ver o que mudaria.
Por fim, o modelo foi construído para ser atualizado em camadas. Quando sai uma pesquisa nova, ela entra no componente correspondente e só ele é recalculado. Por isso os números aqui vão mudar nos próximos dias. Vou atualizar números e gráficos a cada nova pesquisa relevante até sábado, 24 de outubro, último dia antes do segundo turno. A data e a pesquisa mais recente incorporada aparecem sempre no topo do post. Se você voltar aqui nos próximos dias, vai encontrar a versão mais atual do modelo, não um retrato congelado do dia em que este texto foi publicado.
O que as urnas já disseram
Toda modelagem precisa de um ponto de partida firme, no nosso caso é o resultado do primeiro turno. Diferente de uma pesquisa, ele não é uma estimativa sobre o que as pessoas dizem que vão fazer, mas sim o registro do que fizeram. Por isso o modelo o trata como uma âncora empírica, em outras palavra, como o dado mais confiável de todo o exercício, ao qual as demais informações se ajustam. Com 99,99% das urnas apuradas, o resultado foi o seguinte: Flávio Bolsonaro 47,03% e Lula 45,16%. Essa é a base de apoio observada. Os votos em disputa dos demais candidatos (transferência) foi por volta de 7,81%.
A leitura desses números é direta, os dois candidatos chegam ao segundo turno com bases quase do mesmo tamanho e a disputa se decide essencialmente em dois grupos. O primeiro deles é os cerca de 7,8% que votaram em outros candidatos, principalmente Augusto Cury, Renan Santos e Ronaldo Caiado. Esses eleitores agora precisam escolher entre os dois finalistas, votar branco, nulo ou não comparecer. O segundo é quem não votou de maneira válida no primeiro turno, ou seja, os que se abstiveram, votaram branco ou nulo. Parte deles pode voltar ao jogo agora, por isso trato desse grupo em uma seção própria.
Há um terceiro movimento possível, os eleitores que votaram em um finalista no primeiro turno e mudam de lado no segundo. As pesquisas indicam que esse fluxo existe, mas é pequeno, da ordem de 1 a 2% de cada base e, em boa medida, se compensa. Por isso o modelo concentra sua atenção nos dois grupos acima.
A âncora usada importa porque ela funciona como um teste de coerência. Se as pesquisas de segundo turno apontassem um resultado impossível de alcançar a partir do primeiro turno, por exemplo uma vitória folgada que exigisse que quase todos os eleitores dos demais candidatos migrassem para um só lado, isso seria um sinal de alerta. Hoje não é o caso, as pesquisas e a aritmética do primeiro turno apontam na mesma direção e para uma faixa parecida. Essa convergência é, em si, uma informação útil.
Um detalhe técnico atravessa todo o modelo, os números são sempre expressos em votos válidos e o motivo é a regra eleitoral. Pela Constituição, vence a eleição presidencial quem obtém a maioria absoluta dos votos, sem contar os brancos e os nulos. No segundo turno, portanto, quem tiver mais de 50% dos votos válidos vence. Votos brancos e nulos não “vão para ninguém” e não alteram a divisão entre os candidatos, apenas reduzem o total sobre o qual a porcentagem é calculada. Por isso, antes de entrar no modelo, toda pesquisa é convertida para a mesma escala. A conta é simples, divide-se o percentual de cada candidato pela soma dos dois. Por exemplo, uma pesquisa divulga 45% para o candidato A, 43% para o candidato B e 12% de brancos, nulos e indecisos. Em votos válidos, A teria 45 ÷ 88 ≈ 51,1% e B, 43 ÷ 88 ≈ 48,9%.
Repare que a diferença entre os candidatos parece maior no voto total (2 pontos) do que no voto válido (2,2 pontos). Não houve mudança no eleitorado, apenas uma mudança de régua. Reconheço que converter para votos válidos implica a suposição de que os indecisos se distribuirão entre os candidatos na mesma proporção dos decididos ou deixarão de votar validamente. É a convenção usada pelos próprios institutos, o que é bastante razoável quando os indecisos são poucos, como agora, a poucos dias da eleição. Mas é uma premissa, não um fato. Se os indecisos penderem desproporcionalmente para um lado, o resultado real se afastará das estimativas. Essa é uma das fontes de incerteza que o modelo tenta acomodar mais adiante.
Como o modelo funciona
O modelo combina quatro componentes, cada um respondendo a uma pergunta diferente sobre o segundo turno. A estimativa final é uma média ponderada dos quatro.
| Componente | Pergunta que responde | Peso |
| P – Agregado de pesquisas | O que as pesquisas de segundo turno dizem, em conjunto? | 50% |
| T – Transferência de votos | Dado o 1º turno, para onde vão os eleitores dos candidatos derrotados? | 25% |
| E – Modelo expandido | E se incluirmos quem não votou validamente no 1º turno? | 15% |
| R – Tendência recente | Para que lado as pesquisas mais recentes estão se movendo? | 10% |
Em forma de equação, sendo V a fatia de votos válidos de um candidato:
V = 0,50·P + 0,25·T + 0,15·E + 0,10·R
A fatia do outro candidato é simplesmente 100 − V.
A seguir, explico cada componente. A transferência e o modelo expandido ganham seções próprias mais adiante, porque são a parte mais original do exercício.
P – O agregado de pesquisas (50%)
É o coração do modelo, ele reúne as pesquisas recentes de segundo turno, todas convertidas para votos válidos, e calcula uma média ponderada. Entraram no modelo, ao longo de sua construção, pesquisas de Datafolha, Quaest, Atlas/Bloomberg, BTG/Nexus, PoderData/Aya, Ipespe/Abrapel, Veritá, Vox Brasil, RealTime Big Data e Palver. Mas nem todas pesam igual. Quatro regras definem quanto cada uma conta.
1. O peso de cada pesquisa decai com o tempo, com uma “meia-vida” de cerca de cinco dias. Uma pesquisa feita há cinco dias vale metade de uma feita hoje, e uma feita há dez dias vale um quarto. A lógica é que o eleitorado se move e uma fotografia antiga diz menos sobre o presente.
2. Quanto menor a margem de erro, maior o peso, como em qualquer média estatística bem feita. Mas aqui há um cuidado importante. A margem de erro divulgada mede apenas o erro amostral, aquele que vem do fato de entrevistarmos uma amostra e não toda a população. Ela não captura as diferenças de método entre institutos, como forma de entrevista, ponderação, formulação das perguntas. Para refletir isso, o modelo soma a cada pesquisa um piso metodológico de 0,75 ponto percentual, combinado à margem de erro como se combinam incertezas independentes (pela raiz da soma dos quadrados). Sem o piso, uma pesquisa com margem de 0,5 ponto pesaria 25 vezes mais do que uma com margem de 2,5 pontos. Com o piso, a vantagem cai para cerca de 8 vezes. Assim, amostras enormes continuam valendo mais, mas não a ponto de engolir todas as outras.
3. Quando um instituto divulga uma nova pesquisa, ela substitui a anterior, em vez de se somar a ela. Se não fosse assim, institutos que publicam com mais frequência teriam mais influência no modelo só por publicarem mais e duas medições feitas com o mesmo método seriam tratadas como evidências independentes, quando não são.
4. Como explicado anteriormente, todas as pesquisas são convertidas para votos válidos antes de entrar na média.
T – A transferência de votos (25%)
Este componente parte do resultado do primeiro turno e pergunta como os eleitores de Cury, Renan e Caiado se redistribuem entre os dois finalistas. Para isso, usa os cruzamentos divulgados por cinco institutos, que perguntaram aos eleitores de cada candidato derrotado em quem votarão agora. É o componente mais “estrutural” do modelo, porque se apoia no voto observado e não apenas em intenções.
E – O modelo expandido (15%)
Este componente toma a transferência como base e acrescenta outro grupo, quem se absteve, votou branco ou nulo no primeiro turno e pode voltar às urnas no segundo. As pesquisas indicam que esse grupo tem preferências diferentes das do eleitorado que votou de maneira válida. Ignorá-lo seria supor que o eleitorado do segundo turno é idêntico ao do primeiro.
R – A tendência recente (10%)
O último componente ajusta uma linha de tendência às pesquisas mais recentes para captar se há um movimento consistente em alguma direção. É o componente mais volátil. Ao longo da construção do modelo, ele mudou de direção várias vezes conforme chegavam pesquisas novas (uma única pesquisa chegou a empurrá-lo para o empate antes de as seguintes o trazerem de volta). Por isso recebe o menor peso.
Por que esses pesos?
Os pesos 50/25/15/10 são escolhas de modelagem, não coeficientes estimados estatisticamente. Prefiro deixar isso claro. A lógica por trás deles é a seguinte:
- O agregador de pesquisas recebe metade do peso porque mede diretamente a disputa que interessa, o segundo turno, entre esses dois candidatos.
- A transferência e o modelo expandido somam 40% porque trazem estrutura comportamental ancorada no primeiro turno. Funcionam como um contrapeso às pesquisas, apoiado em outro tipo de evidência.
- A tendência recebe só 10% porque movimentos de curto prazo podem ser ruído amostral.
Há um detalhe que um(a) leitor(a) atento(a) vai notar, os quatro componentes não são totalmente independentes. O modelo expandido é construído sobre a transferência e a tendência usa as mesmas pesquisas do agregado. Na prática, portanto, o modelo combina duas grandes fontes de evidência, as pesquisas de segundo turno, com cerca de 60% do peso, e o comportamento ancorado no primeiro turno, com cerca de 40%. A divisão em quatro componentes serve para separar perguntas diferentes e apenas isso (não são quatro fontes independentes).
Outros pesos razoáveis levariam a números ligeiramente diferentes. Mas, como os quatro componentes hoje apontam para uma faixa estreita, todos entre 50,5% e 51,5% para o mesmo candidato, mudanças moderadas nos pesos alteram o resultado final em poucos décimos de ponto. Essa robustez é uma das conclusões do exercício.
O modelo não nasceu pronto, evoluiu à medida que novas informações apareciam:
- Primeira versão: uma redistribuição hipotética dos votos dos candidatos derrotados (70% para um lado, 30% para o outro), útil apenas como exercício de sensibilidade.
- Âncora do primeiro turno: com o resultado oficial, o modelo passou a partir do voto real e não mais de pesquisas pré-eleitorais.
- Primeiros dados de transferência: um cruzamento do Datafolha substituiu a divisão arbitrária de 70/30.
- Transferência por candidato: a Quaest passou a separar os eleitores de Cury, Renan e Caiado, revelando que eles se comportam de forma bem diferente.
- Quem não votou: a mesma Quaest mediu as preferências de quem se absteve ou votou branco ou nulo, dando origem ao modelo expandido.
- Agregação de pesquisas: em vez de comparar pesquisas isoladas, o modelo passou a ponderá-las por recência e precisão.
- Conjunto de transferências: como os institutos discordavam muito entre si sobre a migração de votos, a transferência deixou de depender de uma única fonte e passou a combinar cinco.
- Teste de sensibilidade: por fim, acrescentei uma camada separada para testar o efeito de um possível erro comum a todas as pesquisas.
Cada etapa corrigiu uma fraqueza da anterior. Por isso, o modelo continua aberto, quando chega uma pesquisa nova, só a camada correspondente é recalculada.
Para onde vão os votos de Cury, Renan e Caiado
Cerca de 7,8% dos votos válidos do primeiro turno foram para candidatos que ficaram pelo caminho. A primeira versão do modelo supunha, de forma puramente hipotética, que 70% desses votos iriam para um finalista e 30% para o outro. Assim que as pesquisas passaram a perguntar a esses eleitores em quem votarão agora, a suposição foi substituída por dados.
| Instituto | Cury → F | Cury → L | Renan → F | Renan → L | Caiado → F | Caiado → L |
| Quaest (14/10) | 30% | 34% | 40% | 14% | 42% | 23% |
| Palver | 32% | 64% | 41% | 41% | 61% | 35% |
| PoderData | 47% | 36% | 46% | 24% | 50% | 30% |
| Ipespe/Abrapel | 50% | 31% | 40% | 20% | 59% | 18% |
| Datafolha* | 46% | 27% | — | — | — | — |
F = Flávio; L = Lula. O restante corresponde a brancos, nulos e indecisos. *O Datafolha divulgou apenas o bloco dos três candidatos somados.
A tabela mostra que não existe um “eleitor de terceira via” genérico. Os eleitores de Caiado migram com clareza para Flávio em todos os institutos. Os de Renan também pendem para ele, mas com uma fatia grande de brancos e nulos, que chega a 32% no Ipespe. Os de Cury são o caso mais instável, a Palver e a Quaest mostram Lula à frente, enquanto o PoderData e o Ipespe mostram Flávio.
Parte dessa divergência tem explicação estatística, os eleitores de cada candidato derrotado são uma fração pequena da amostra e a margem de erro nesses subgrupos é muito maior do que a da pesquisa como um todo. Por isso, escolher um único instituto seria arriscado, assim o modelo combina os cinco em um conjunto de transferências, no qual nenhuma fonte domina. O resultado dessa camada é: Flávio 51,51% | Lula 48,49%.
Quem não votou no primeiro turno
O eleitorado do segundo turno não é uma cópia do primeiro. Segundo o TSE, cerca de 33 milhões de eleitores (21,08%) se abstiveram no primeiro turno e outros 5,9 milhões votaram branco (1,84%) ou nulo (2,93%). Uma parte dessas pessoas pode votar agora e outra parte de quem votou pode ficar em casa.
O que importa é que esse grupo não pensa como a média. Na Quaest de 14 de outubro, entre quem se absteve ou votou branco ou nulo no primeiro turno, 43% declararam voto em Lula e 38% em Flávio, e 17% disseram que vão votar branco, nulo ou não votar. A rodada de 21 de outubro mostrou um quadro parecido, 40% a 36%, com 21% fora do voto válido.
O modelo expandido parte da camada de transferência e acrescenta o retorno de parte desse grupo, de forma conservadora. Dizer a um pesquisador que vai votar não é o mesmo que ir à urna, então o modelo não supõe que todos voltem. Como esse eleitorado pende levemente para Lula, o efeito é estreitar a diferença: Flávio 50,52% | Lula 49,48%.
O resultado atual
Combinando os quatro componentes com seus pesos, a estimativa central do modelo, atualizada em 22 de outubro, é: Flávio 50,99% | Lula 49,01% (votos válidos).
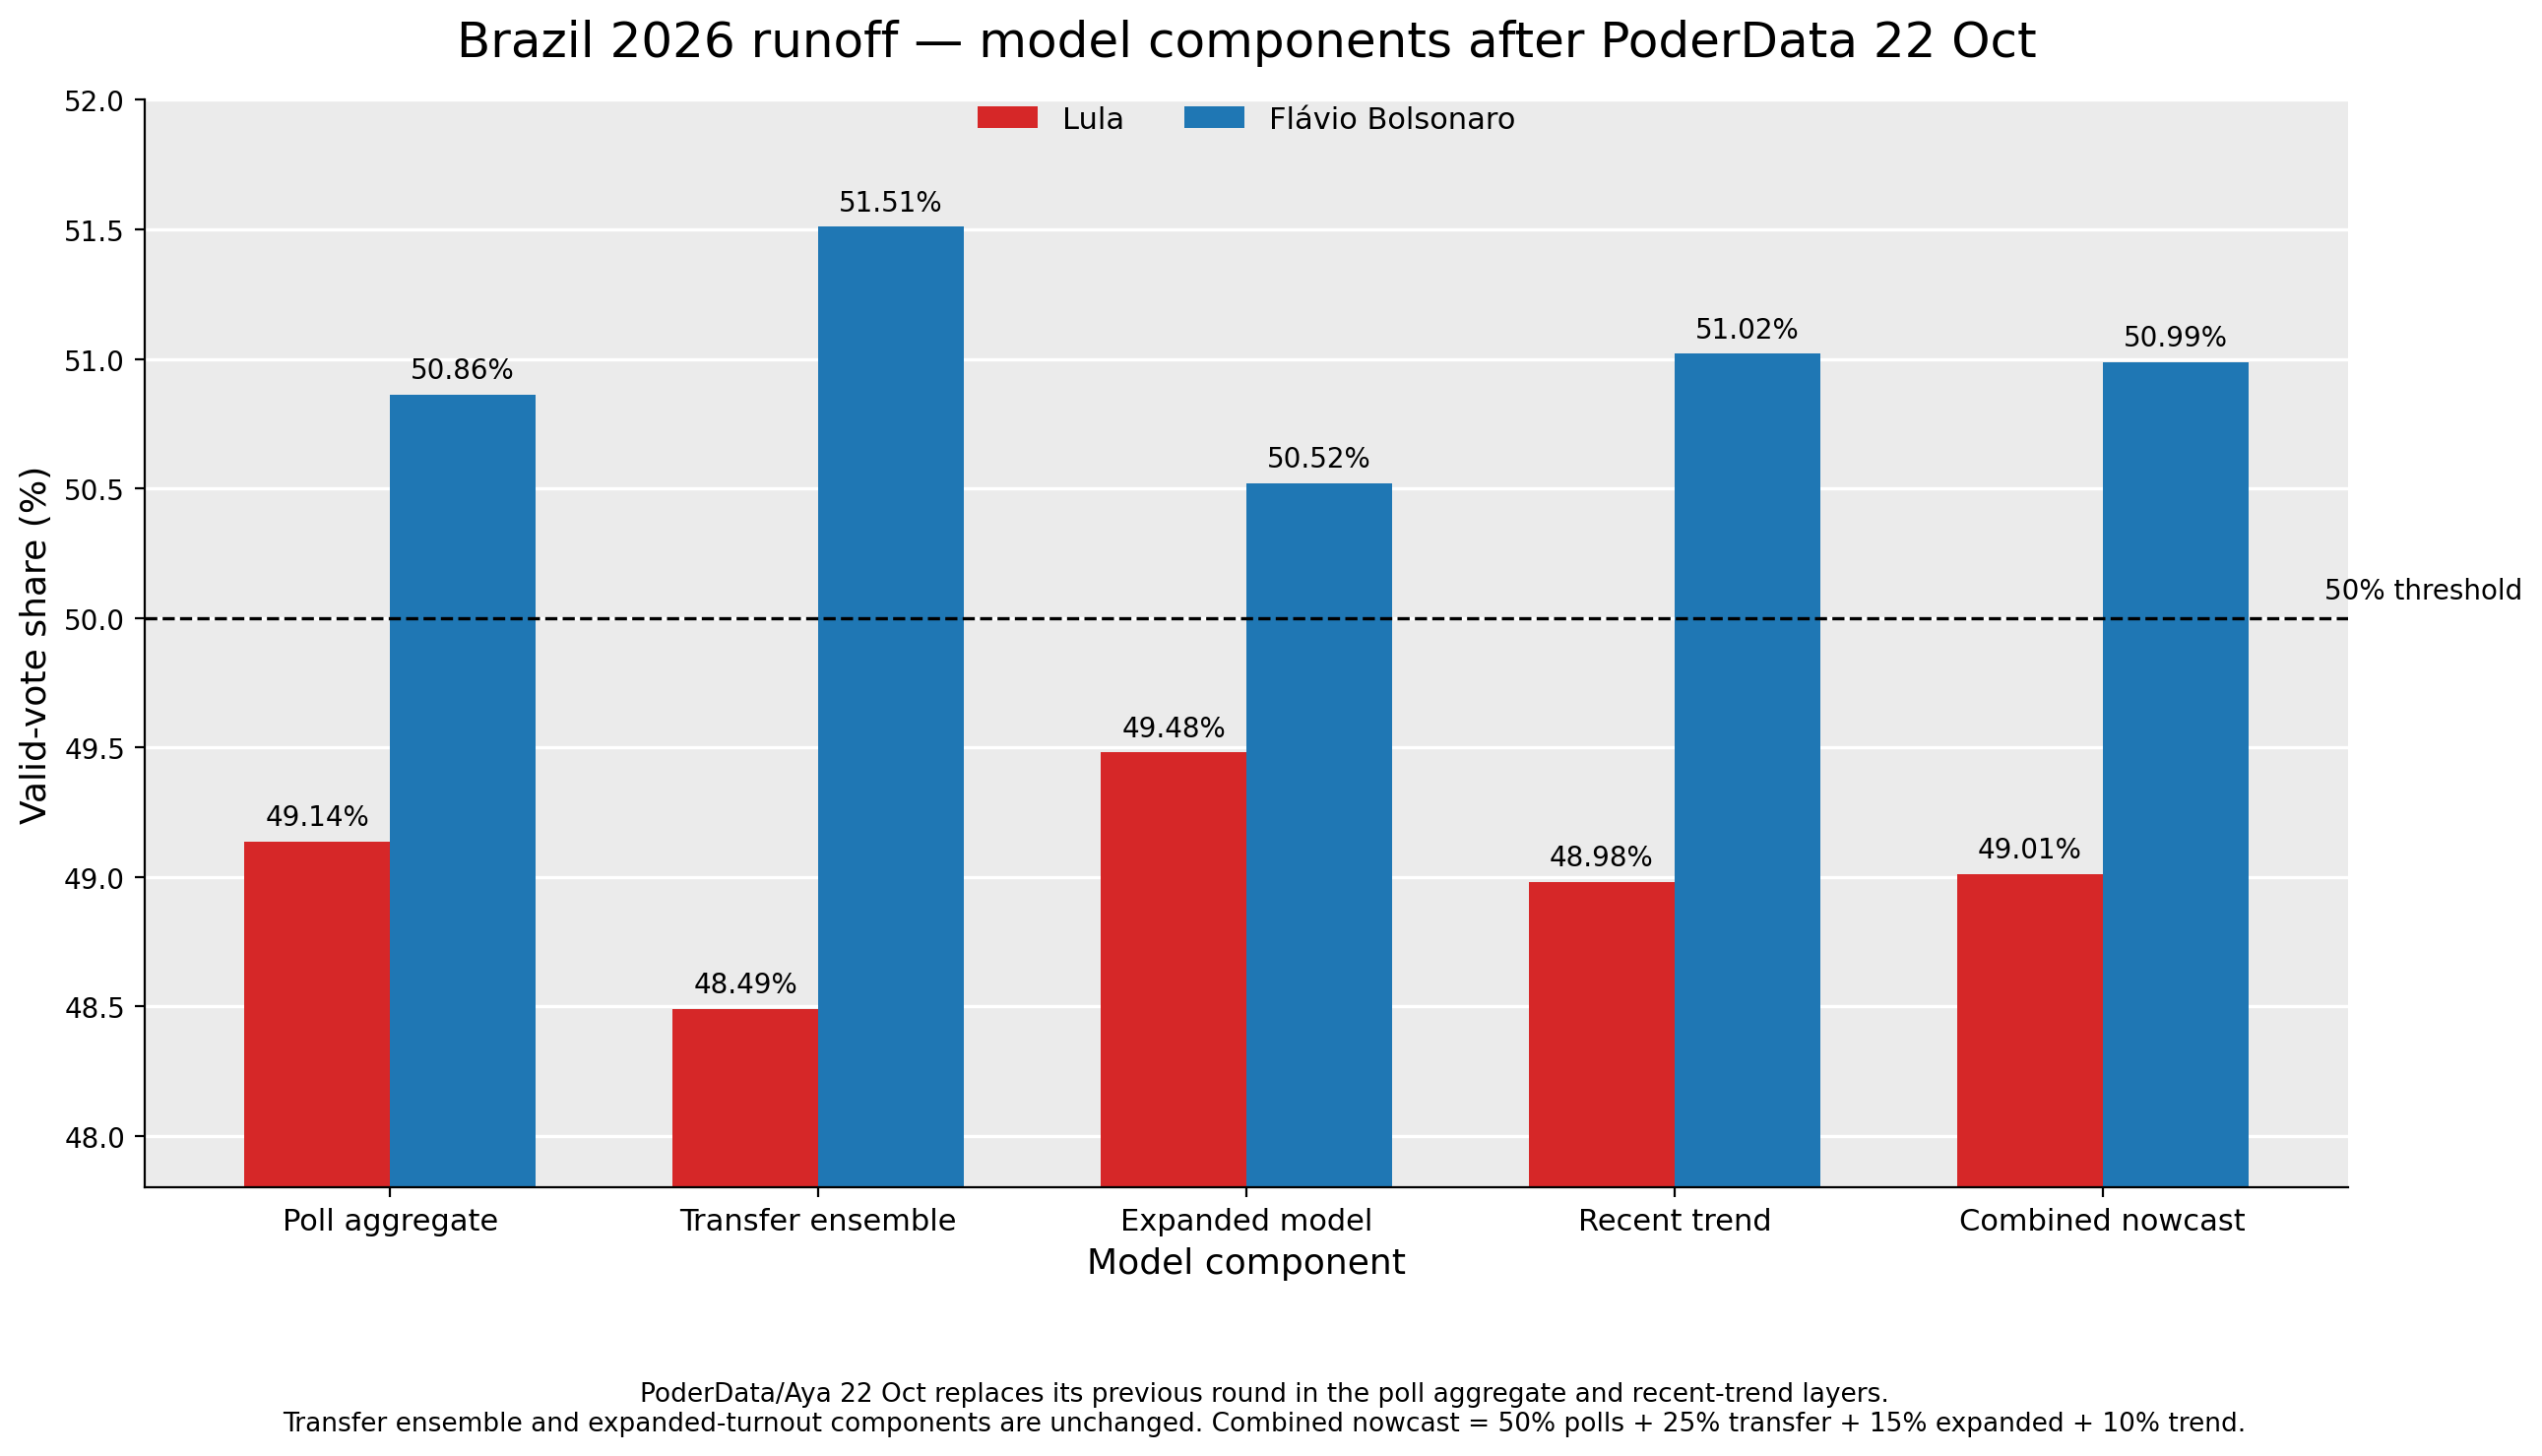
Figura 1: Componentes do modelo e estimativa combinada, em votos válidos. A linha tracejada marca 50%. (Gráfico em inglês: “Poll aggregate” = agregado de pesquisas; “Transfer ensemble” = transferência; “Expanded model” = modelo expandido; “Recent trend” = tendência; “Combined nowcast” = estimativa combinada.)
Os quatro componentes apontam para o mesmo lado e para uma faixa estreita, entre 50,5% e 51,5%. Isso torna o resultado pouco sensível aos pesos escolhidos.
O que mudou com a pesquisa PoderData de 22/10? A nova rodada (51% a 49%) substituiu a anterior do mesmo instituto (52% a 48%). Ao mesmo tempo, o passar dos dias reduziu o peso de pesquisas mais antigas que eram um pouco mais favoráveis a Flávio. O resultado foi um leve deslocamento em direção a Lula, a estimativa passou de 51,05% para 50,99%. É uma mudança de seis centésimos, bem dentro do que se espera de uma atualização.
Por que 51 a 49 não é certeza?
Uma estimativa central sozinha engana em uma disputa tão apertada. Para medir a incerteza, o modelo usa simulação de Monte Carlo, recalcula o resultado milhares de vezes, sorteando variações plausíveis em cada componente e acrescentando um erro comum a todos. O resultado é uma faixa de valores, e não um número único.
| Estimativa central (Flávio) | Faixa de 80% | Faixa de 95% | |
| Cenário neutro | 50,99% | 50,01% – 51,97% | 49,47% – 52,50% |
Duas leituras importam aqui. A primeira, é que o limite inferior da faixa de 80% está em 50,01%, praticamente em cima da linha de 50%. A segunda, a faixa de 95% cruza os 50%. Em outras palavras, o modelo aponta uma vantagem pequena, mas um resultado favorável a Lula continua dentro do que é plausível. Essas faixas expressam a incerteza do modelo, dadas as premissas adotadas.
E se as pesquisas errarem todas na mesma direção?
Nas últimas semanas, dois especialistas do setor levantaram publicamente essa hipótese, são eles um ex-dirigente de um dos maiores institutos de pesquisa do país e um executivo de um instituto internacional. Os argumentos foram de que parte do eleitorado de direita pode estar sub-representada, seja por recusar entrevistas, por morar em áreas de difícil acesso aos pesquisadores ou por limitações nos cadastros telefônicos, e de que erros de pesquisa tendem a ser correlacionados entre institutos e não de maneira independente.
O modelo não assume que isso seja verdade. Em vez disso, testa quanto o resultado mudaria se fosse. Supõe-se um viés comum de b pontos. Ele é aplicado integralmente ao agregado de pesquisas e à tendência, e pela metade às camadas de transferência e expandida, que já estão parcialmente ancoradas no voto real do primeiro turno. No resultado final, cada ponto de viés se traduz em 0,8 ponto de deslocamento.
| Cenário | Viés suposto | Flávio | Lula | Faixa de 80% (Flávio) | Faixa de 95% (Flávio) |
| Neutro | 0 | 50,99% | 49,01% | 50,01 – 51,97 | 49,47 – 52,50 |
| Sub-representação leve | +0,75 pp | 51,59% | 48,41% | 50,60 – 52,58 | 50,07 – 53,10 |
| Sub-representação forte | +1,50 pp | 52,19% | 47,81% | 51,20 – 53,18 | 50,68 – 53,70 |
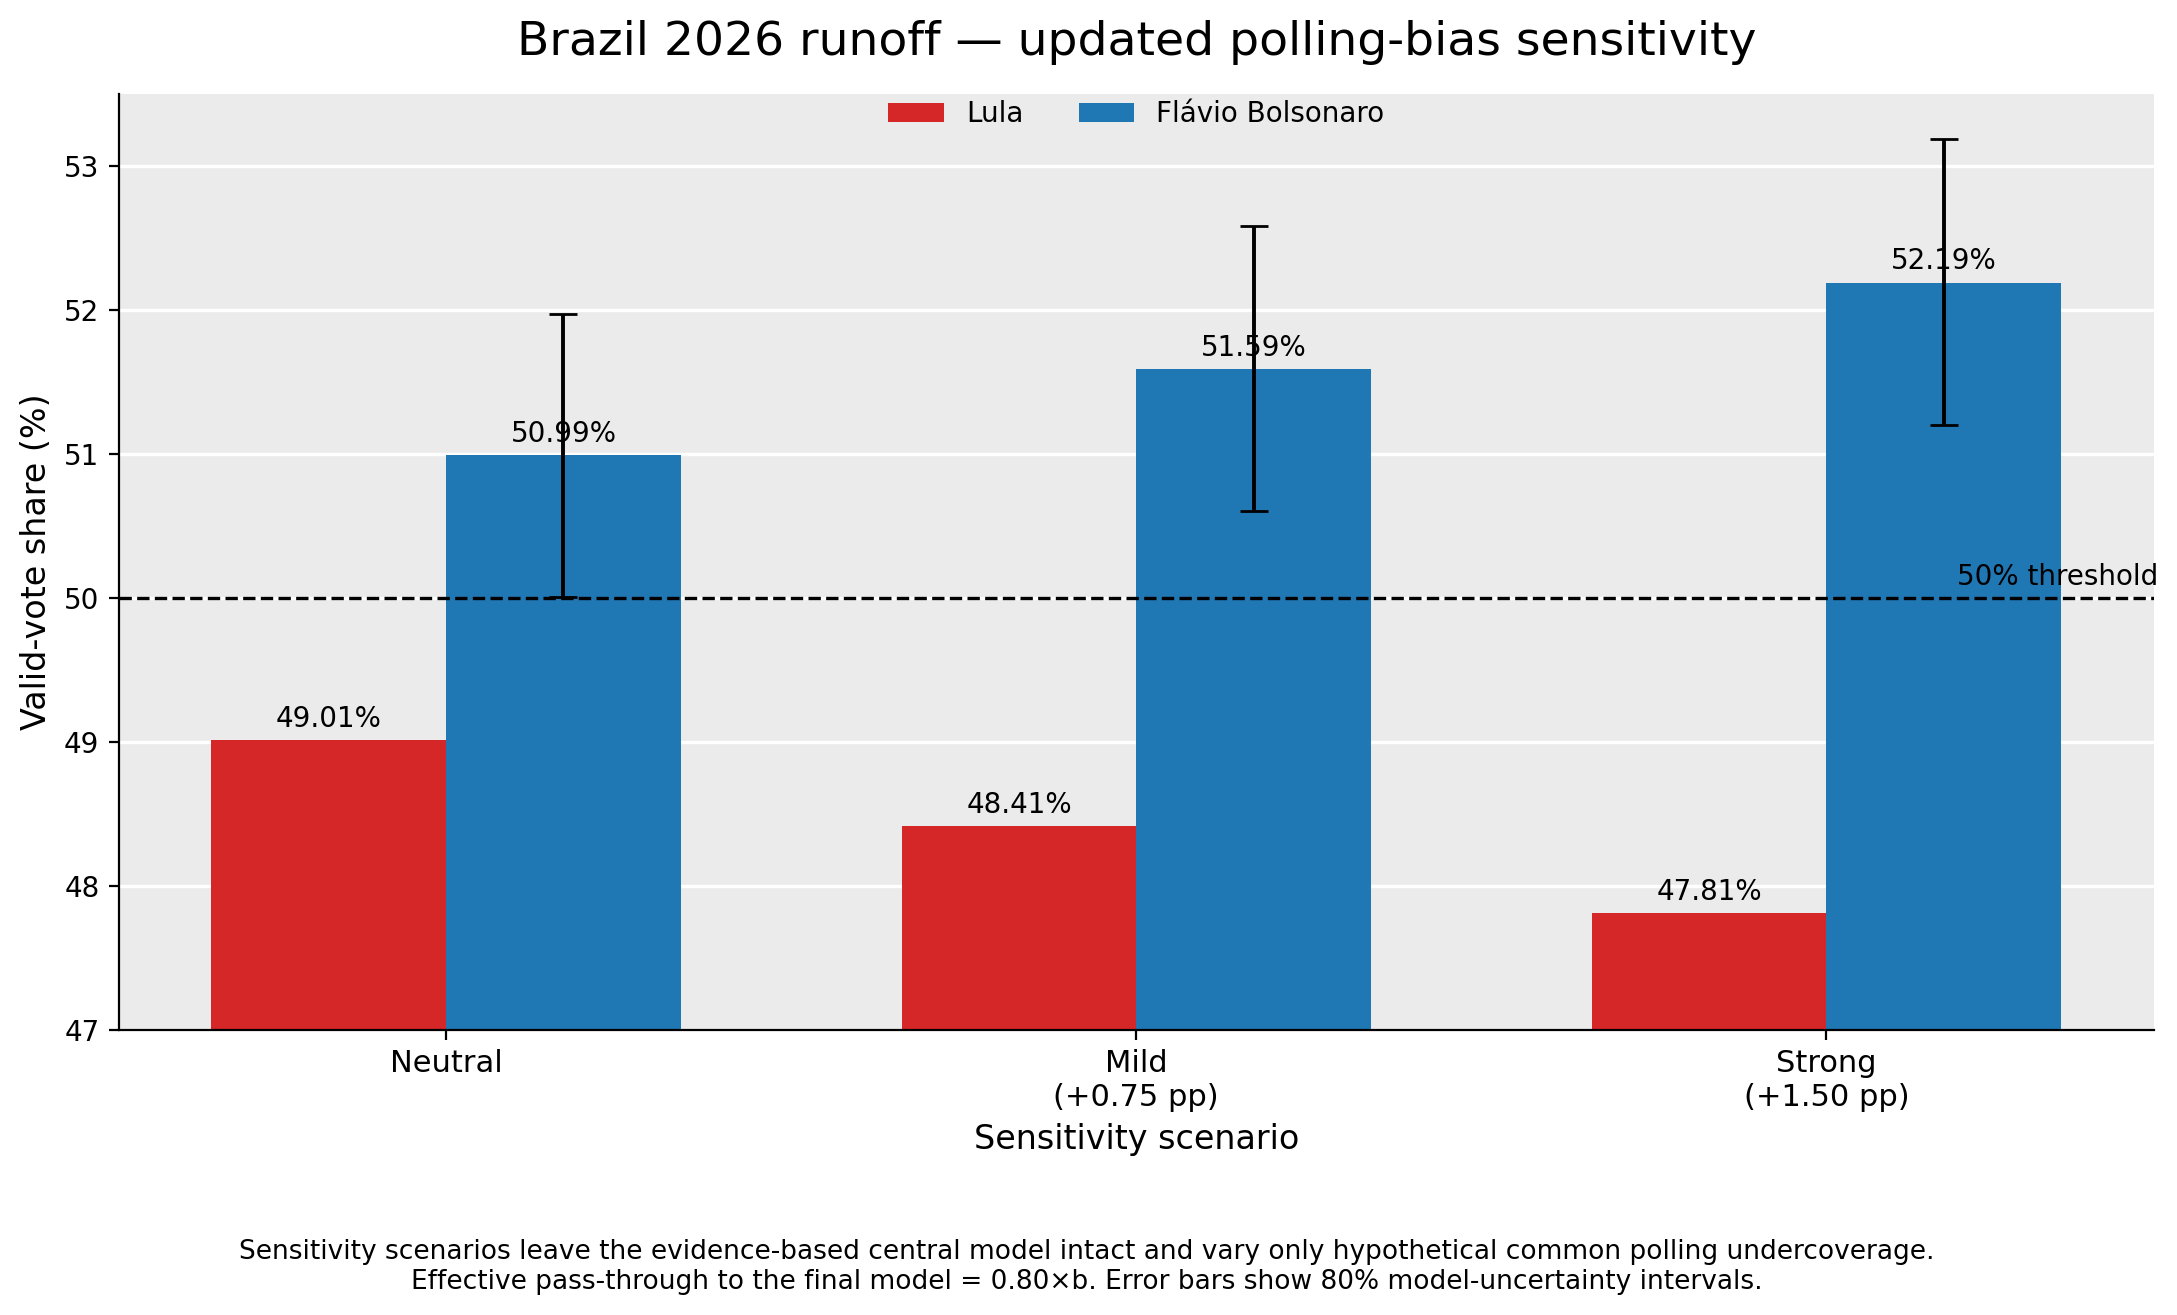
Figura 2: Legenda sugerida: Estimativa central em cada cenário de viés hipotético. As barras de erro mostram as faixas de 80%. (Gráfico em inglês: “Neutral” = neutro; “Mild” = leve; “Strong” = forte.)
É preciso cuidado na leitura. Nos cenários com viés, as faixas inteiras ficam acima de 50%, mas isso só vale se o suposto viés existir, e não há evidência medida de que exista, nem de qual seria seu tamanho. Este é um teste de robustez que olha em uma única direção porque foi essa a hipótese levantada. Um erro no sentido oposto deslocaria o resultado na mesma proporção a favor de Lula.
Como todo modelo, este tem limites que convém deixar claros. Os pesos de cada componente são escolhas de modelagem e não coeficientes estimados a partir do desempenho em eleições passadas. Os cruzamentos de transferência se apoiam em subamostras pequenas e variam bastante entre institutos e entre rodadas. O modelo também não estima o viés próprio de cada instituto, o piso metodológico limita a influência de qualquer pesquisa isolada, mas não identifica tendências sistemáticas. O comparecimento é outro ponto difícil de prever, já que dizer que vai votar não garante o voto. Fatos de última hora, como debates, denúncias, mobilização ou abstenção estratégica, ficam fora do modelo e os cenários de viés são hipotéticos, sem medir um erro real. Por fim, o modelo não calcula a probabilidade de vitória de nenhum candidato. Para isso, seria preciso calibrá-lo com o histórico de erros de eleições anteriores.
O valor deste exercício não está na segunda casa decimal, mas na disciplina de separar o que é evidência (pesquisas, voto do primeiro turno, migração medida), o que é premissa (pesos, comparecimento) e o que é teste de sensibilidade (o viés hipotético). Hoje, a evidência aponta para uma disputa muito próxima de 51 a 49, com uma incerteza grande o bastante para que qualquer resultado entre os dois candidatos seja plausível.
Referências
- Folha de S.Paulo (5/10/2026). Resultado do 1º turno. https://www1.folha.uol.com.br/internacional/en/brazil/2026/10/gap-between-flavio-and-lula-is-smallest-ever-in-first-round-of-presidential-election.shtml
- UOL (17/10/2026). Para onde vão os votos de Cury, Renan e Caiado, segundo 4 pesquisas. https://noticias.uol.com.br/eleicoes/2026/10/17/pesquisas-destino-votos-cury-renan-caiado.ghtm
- UOL (14/10/2026). Quaest: segundo turno e transferência de votos. https://noticias.uol.com.br/eleicoes/2026/10/14/quaest-presidencial-intencao-de-voto-segundo-turno.ghtm
- UOL/Agência Estado (21/10/2026). Quaest: entre ausentes, brancos e nulos no 1º turno, 40% votam em Lula e 36% em Flávio. https://noticias.uol.com.br/ultimas-noticias/agencia-estado/2026/10/21/quaest-entre-ausentesbrancosnulos-no-1-turno-40-votam-em-lula-e-36-em-flavio.htm
- Seu Dinheiro (17/10/2026). Pesquisa Ipespe. https://www.seudinheiro.com/2026/politica/pesquisa-ipespe-lula-ganha-terreno-e-diferenca-para-flavio-bolsonaro-cai-tres-pontos-mlim/
- Folha de S.Paulo (16/10/2026). Datafolha: 51% a 49% dos votos válidos. https://www1.folha.uol.com.br/internacional/en/brazil/2026/10/datafolha-flavio-bolsonaro-has-51-and-lula-49-of-valid-votes-a-technical-tie.shtml
- Poder360 (22/10/2026). PoderData/Aya. https://www.poder360.com.br/poderdata/flavio-tem-51-e-lula-tem-49-dos-votos-validos-diz-poderdata-aya/
- UOL (22/10/2026). Pesquisas de segundo turno por instituto. https://noticias.uol.com.br/eleicoes/2026/10/22/pesquisa-segundo-turno-presidente-2026-veja-os-numeros-de-cada-instituto.ghtm

