Foi 51 a 49, só que ao contrário (a anatomia de um erro)
outubro 28, 2026 § Deixe um comentário
O TSE confirmou Lula reeleito com 51,79% dos votos válidos, contra 48,21% de Flávio Bolsonaro, uma diferença de 4,4 milhões de votos. Três semanas antes, no primeiro turno, Flávio tinha terminado à frente por 2,2 milhões. Na véspera da eleição, a versão final do modelo que apresentei aqui apontava o contrário, 51,06% para Flávio e 48,94% para Lula, um erro de 2,85 pontos percentuais.
Ao divulgar a última atualização, propus um critério para julgar o modelo depois do resultado, checar se a realidade havia caído dentro das faixas de incerteza. Por esse critério, o modelo falhou. A faixa de 95% ia de 49,54% a 52,57% para Flávio e o resultado ficou 1,33 ponto abaixo do seu limite inferior. Mas o modelo não errou sozinho.
Todos os seus componentes e todas as pesquisas finais de segundo turno erraram na mesma direção, superestimando Flávio entre 2,3 e 3,8 pontos. De qualquer forma, entendo que isso não absolve a modelagem feita. Ela foi construída justamente para não depender de uma única fonte e para levar em conta a possibilidade de um erro comum das pesquisas. Se mesmo assim errou fora da sua própria margem, algo na sua estrutura precisa ser revisto. É isso que pretendo fazer neste texto.
Minha ideia é comparar o que o modelo disse com o que aconteceu, identificando onde ele errou, mostrando de onde veio a vitória de Lula e apresentando algumas hipóteses para o que as pesquisas não viram. Prefiro publicar uma análise honesta a deixar o modelo anterior falando sozinho.
Para início de conversa, a forma mais direta de avaliar o modelo seria colocar lado a lado cada uma das suas peças, as pesquisas finais e o resultado oficial.
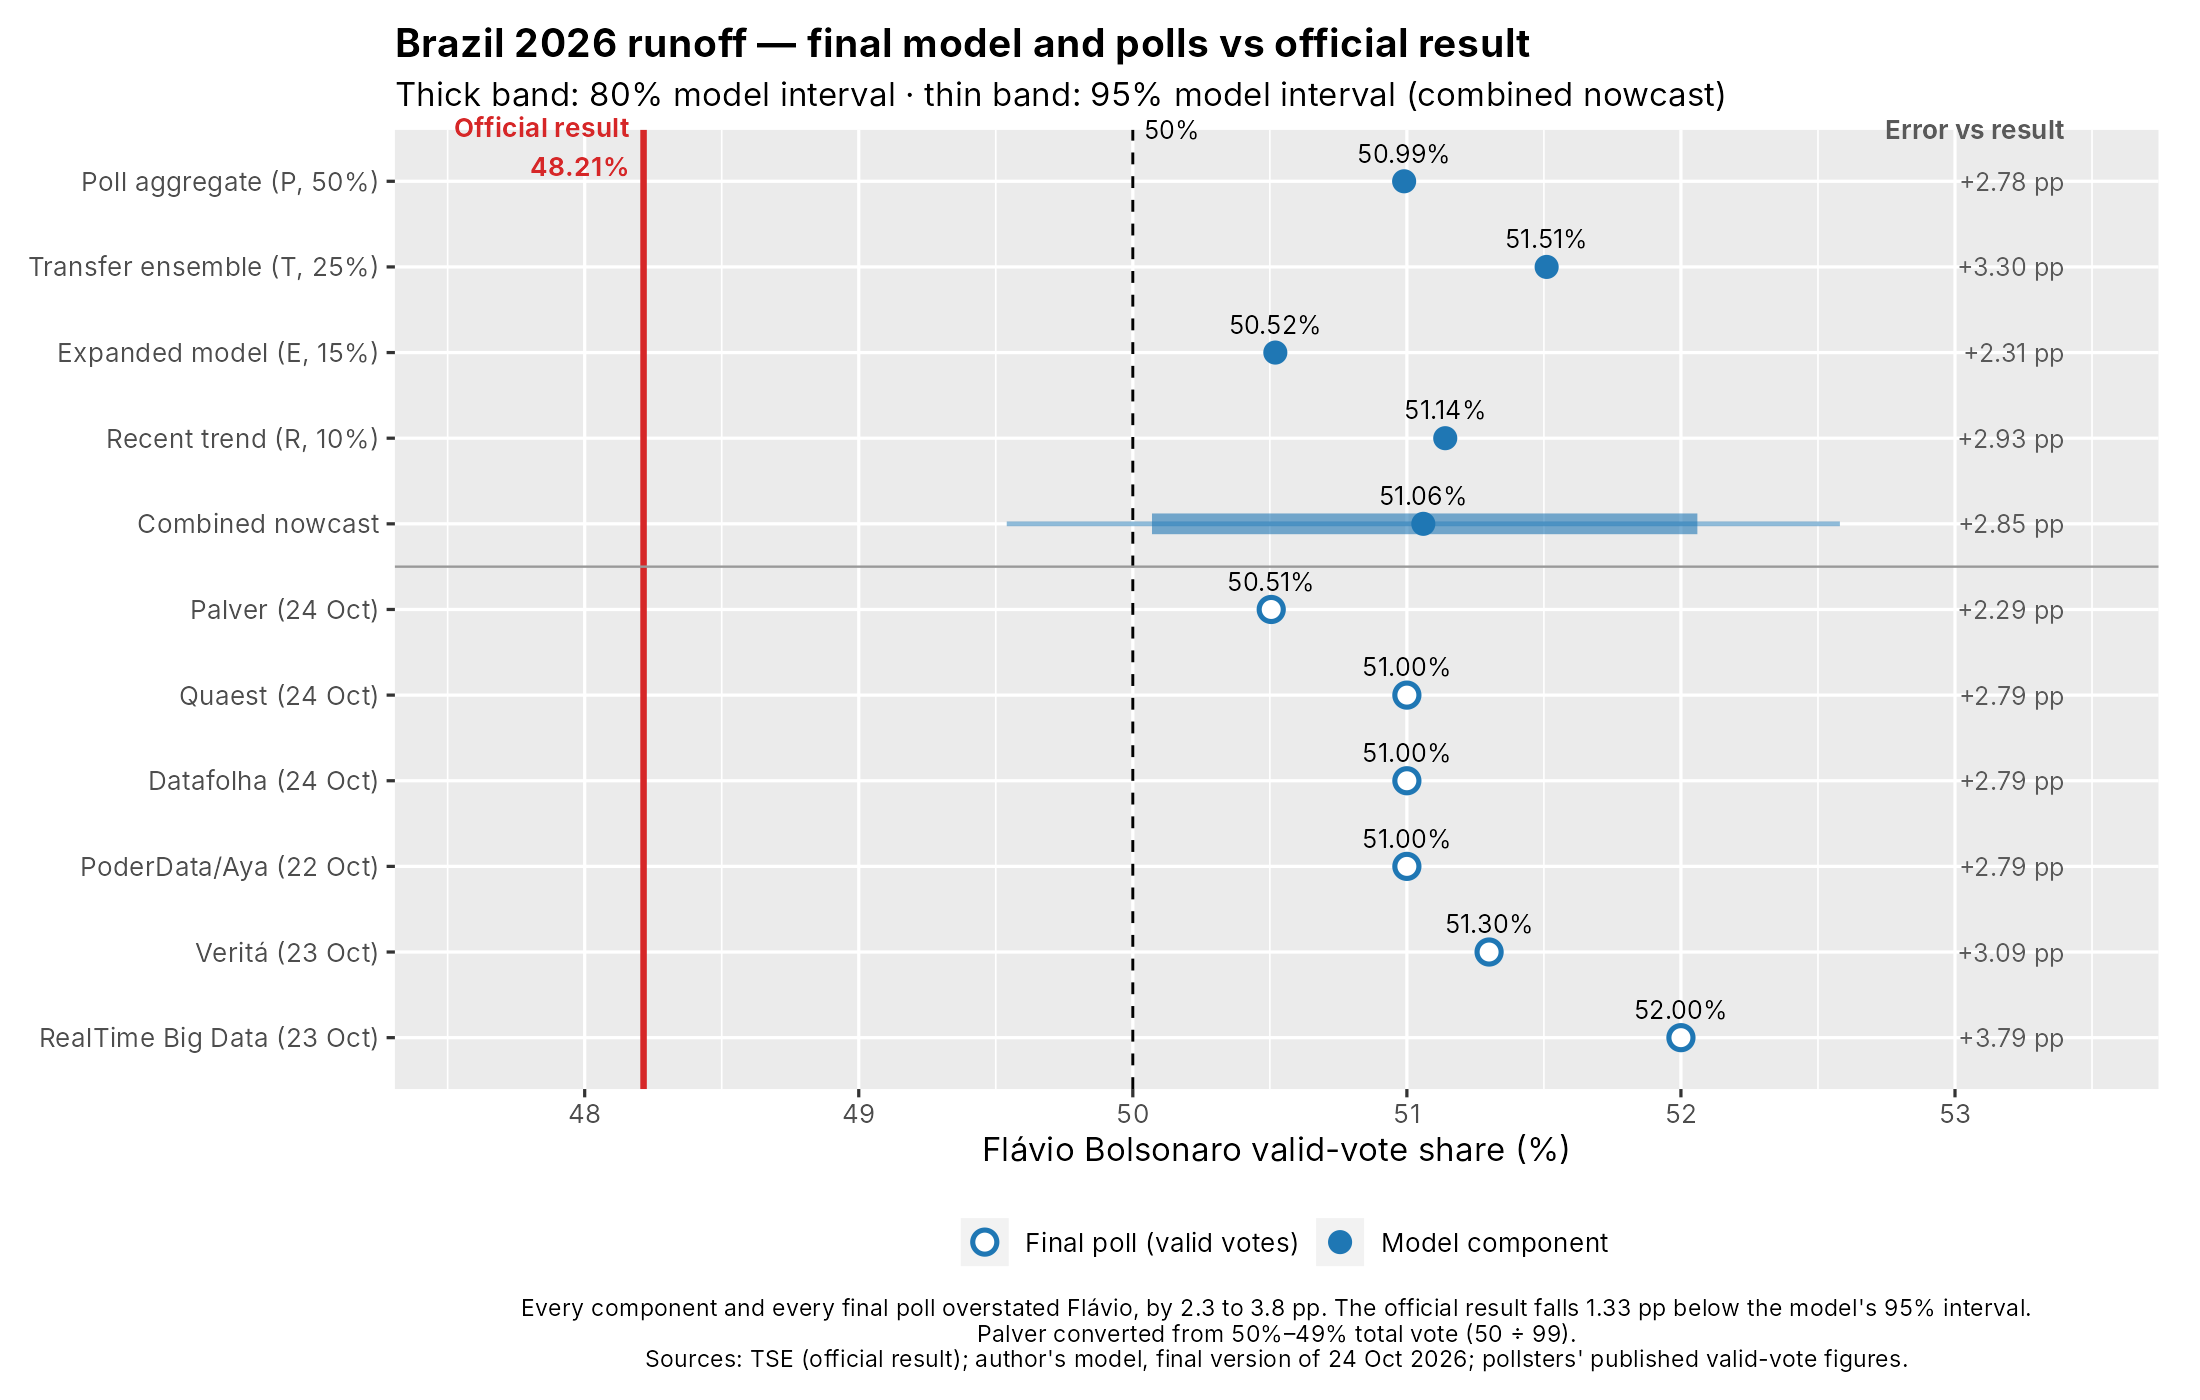
Figura 1: Componentes do modelo e pesquisas finais, comparados ao resultado oficial (linha vermelha). A faixa grossa é o intervalo de 80% da estimativa combinada; a fina, o de 95%. Gráfico em inglês.
| Análise | Flávio (previsto) | Erro em relação ao resultado |
| Agregado de pesquisas (50%) | 50,99% | +2,78 pp |
| Transferência de votos (25%) | 51,51% | +3,30 pp |
| Modelo expandido (15%) | 50,52% | +2,31 pp |
| Tendência recente (10%) | 51,14% | +2,93 pp |
| Estimativa combinada | 51,06% | +2,85 pp |
| Palver (24/10) | 50,51% | +2,29 pp |
| Quaest (24/10) | 51,00% | +2,79 pp |
| Datafolha (24/10) | 51,00% | +2,79 pp |
| PoderData/Aya (22/10) | 51,00% | +2,79 pp |
| Veritá (23/10) | 51,30% | +3,09 pp |
| RealTime Big Data (23/10) | 52,00% | +3,79 pp |
Tabela 1: Resultado oficial, Flávio 48,21%. Erro positivo significa que a fonte superestimou Flávio.
Três coisas saltam aos olhos. A primeira é que todos erraram para o mesmo lado. Nenhuma pesquisa e nenhum componente do modelo chegaram perto de 48%. As pesquisas finais superestimaram Flávio, em média, 2,9 pontos (foi o conjunto todo fora da curva). Segundo, as pesquisas concordavam entre si e foi essa concordância que gerou o engano. As seis pesquisas finais ficaram dentro de uma faixa de apenas 1,5 ponto, entre 50,5% e 52%. Em geral, quando institutos com métodos diferentes chegam a números parecidos, ganhamos confiança. Mas agregar fontes só reduz o erro quando os erros de cada uma são independentes e tendem a se compensar. Quando todas erram na mesma direção, a média apenas reproduz o erro comum, com uma aparência de precisão maior. Foi exatamente o que aconteceu com o agregado de pesquisas do modelo.
A terceira é que as peças que apontavam para Lula foram as que mais se aproximaram do resultado. O modelo expandido, que incorporava o retorno de quem não votou no primeiro turno e por isso puxava a estimativa em direção a Lula, foi o componente que menos errou (+2,31 pp). Entre as pesquisas, a mais próxima foi a Palver (+2,29 pp), justamente a que vinha mostrando a disputa mais apertada e a migração mais favorável a Lula entre os eleitores de Cury. No sentido oposto, a camada de transferência de votos, que eu considerava a mais protegida por estar ancorada no voto real do primeiro turno, foi a que mais errou (+3,30 pp). Volto a esse ponto daqui a pouco, porque ele é central para entender a falha.
Onde o modelo errou
Separo a falha em quatro pontos, da mais importante para a menos. Para começar, o que não foi o problema: os pesos. Seria natural suspeitar dos pesos que atribuí a cada componente (50% para as pesquisas, 25% para a transferência, 15% para o modelo expandido e 10% para a tendência), mas a realidade (e a tabela da seção anterior) mostra que eles não explicam a falha. Todos os quatro componentes apontavam vitória de Flávio e o que menos errou, o modelo expandido, ainda indicava 50,52%. Nenhuma combinação de pesos teria produzido uma vitória de Lula, pois o problema estava nas informações que alimentavam o modelo e na forma como ele tratava a incerteza, não na maneira de combiná-las.
O primeiro ponto foi que o teste de viés olhava só para um lado. O modelo tinha uma camada específica para testar a hipótese de que todas as pesquisas errassem juntas, ela foi motivada por dois especialistas do setor que, dias antes da eleição, levantaram publicamente a possibilidade de que as pesquisas estivessem sub-representando o eleitorado de direita. Por isso, testei cenários em que Flávio estaria sendo subestimado em 0,75 e em 1,5 ponto. O erro real foi na direção oposta. Ao construir o teste em um sentido único, deixei de lado a pergunta simétrica, que era igualmente legítima. No primeiro texto, registrei isso apenas como uma ressalva, deveria ter feito as contas.
Depois da eleição, rodei o mesmo teste na direção contrária para entender o comportamento do modelo. O resultado está no gráfico abaixo.
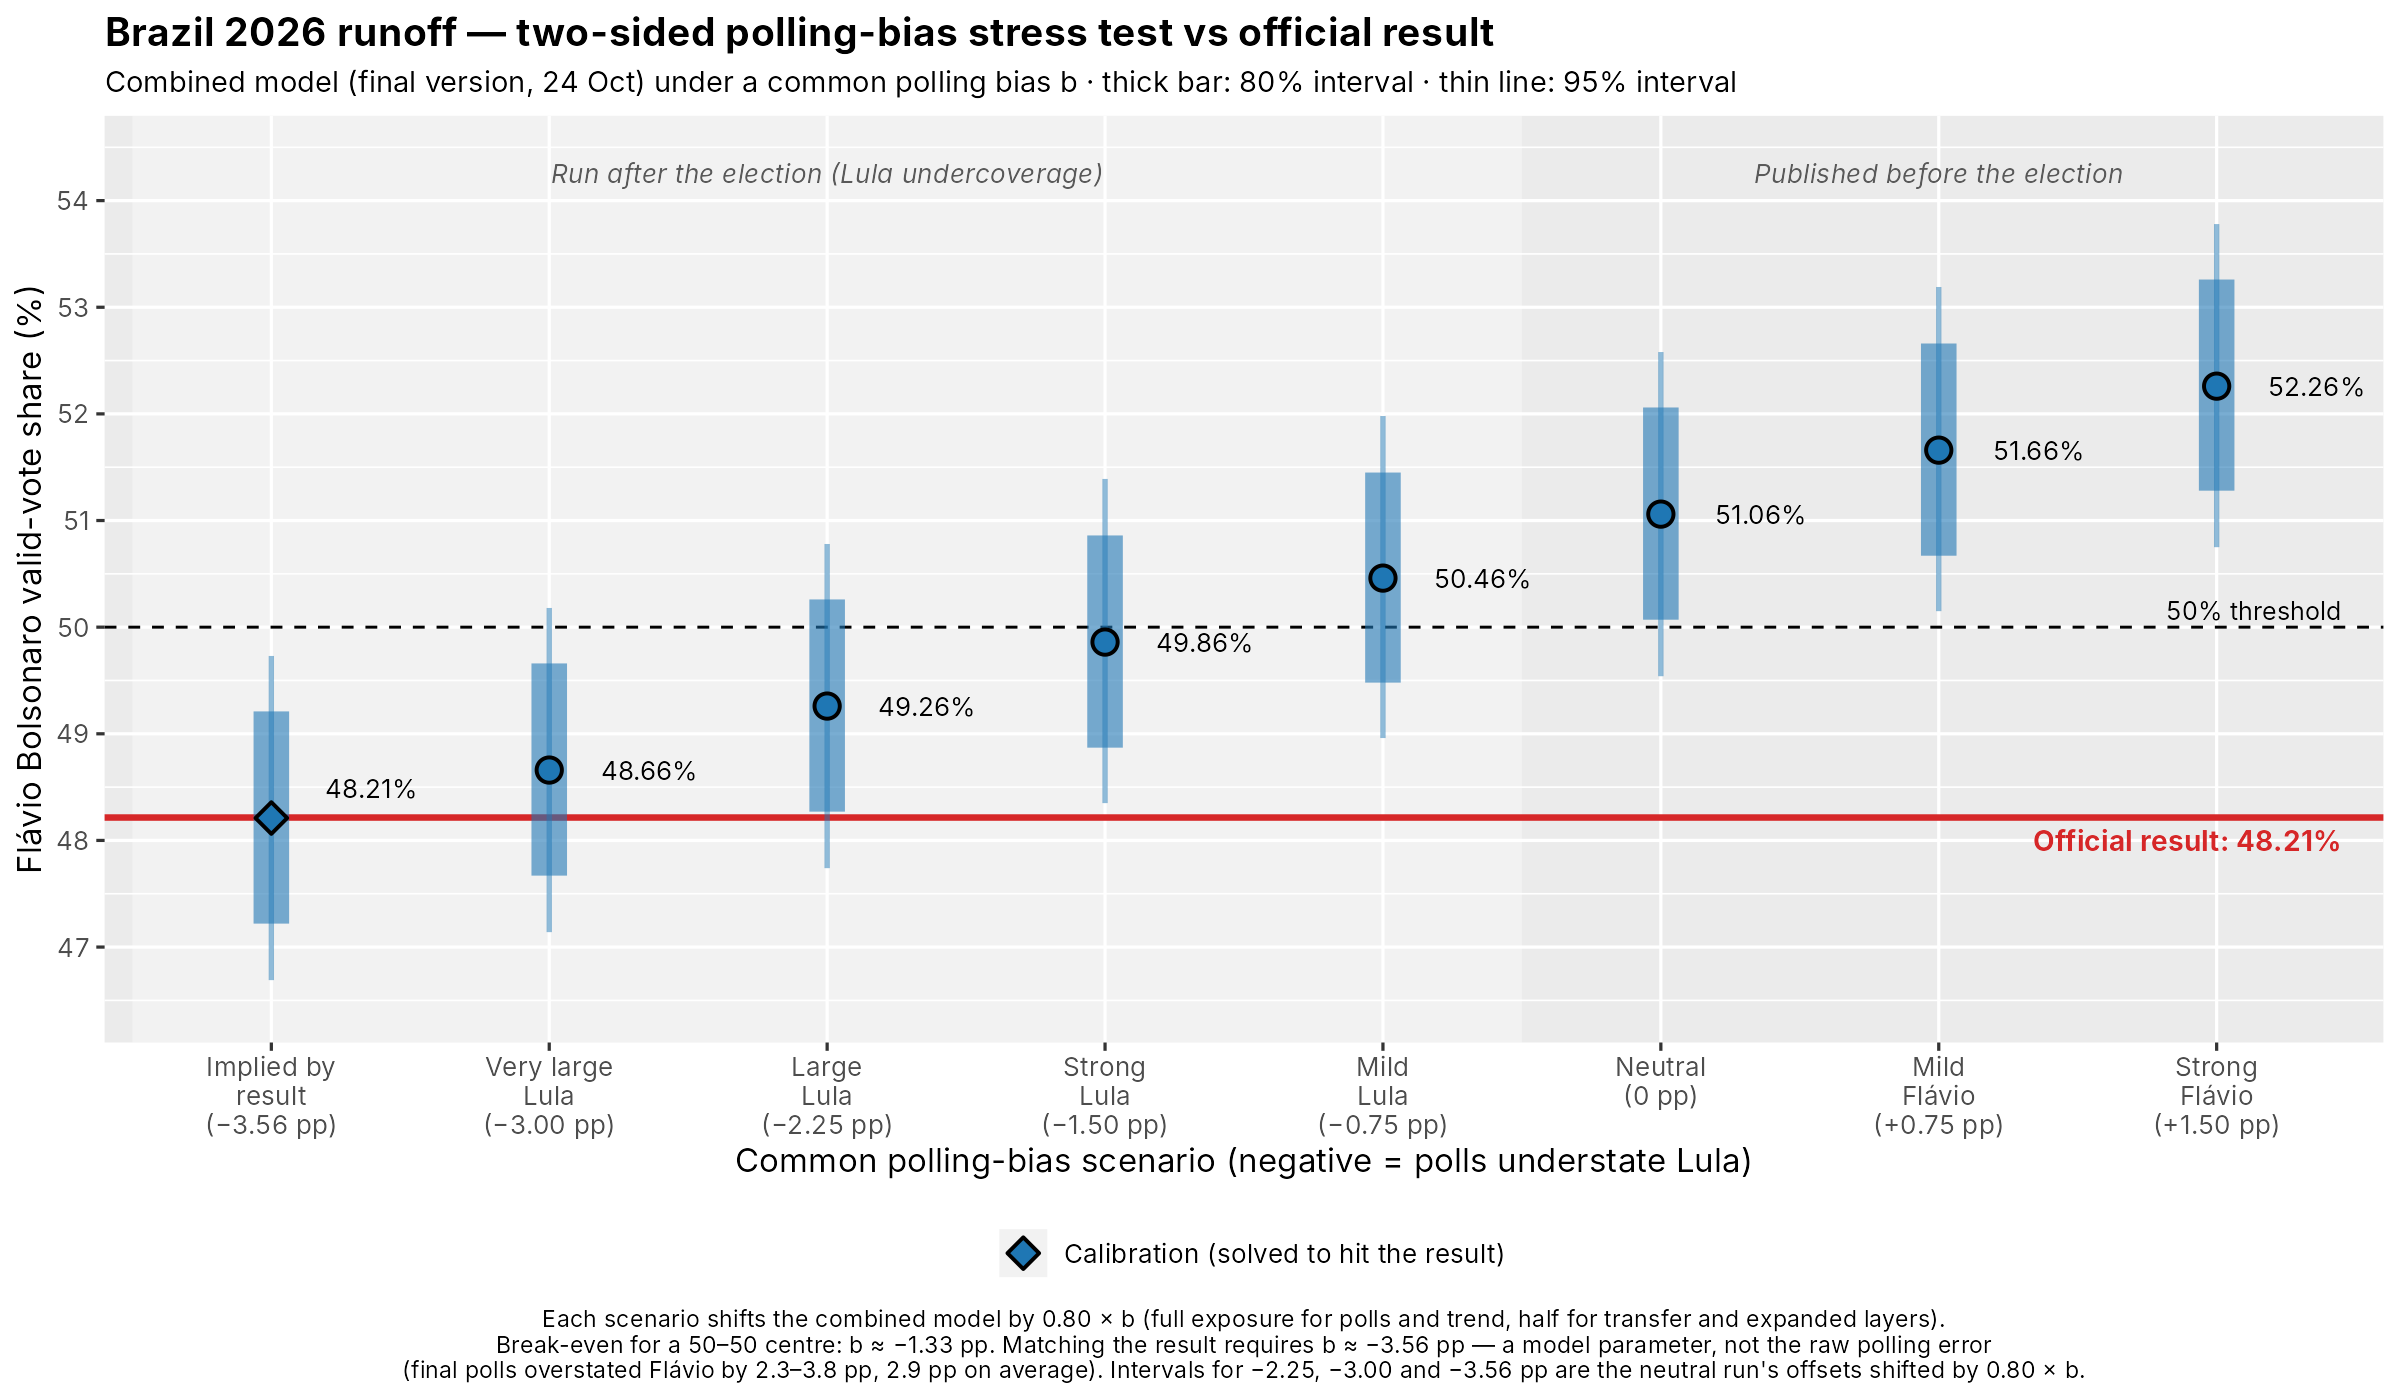
Figura 2: Estimativa combinada do modelo sob diferentes hipóteses de viés comum das pesquisas. À esquerda, cenários de subestimação de Lula, calculados depois da eleição; à direita, os cenários publicados antes dela. A linha vermelha é o resultado oficial. Gráfico em inglês.
Alguns números resumem o teste, 1,33 ponto era o viés comum necessário apenas para levar o modelo ao empate. Com um viés dessa ordem a favor de Lula, a estimativa central já teria se invertido. No cenário “forte” de subestimação de Lula (1,5 ponto), o modelo daria 50,14% para Lula. Mesmo assim, o resultado real ficaria 0,14 ponto fora da faixa de 95% desse cenário. Para acertar exatamente o resultado apenas por essa via, seria preciso um viés de cerca de 3,6 pontos.
Vale um cuidado com este último número, como o modelo supunha que a camada de transferência absorveria só metade de qualquer viés das pesquisas, o valor necessário fica inflado. O erro efetivamente medido nas pesquisas finais foi de 2,9 pontos em média, como vimos no início do texto. Ainda assim, ambos são muito maiores do que o cenário mais extremo que eu havia considerado. Testar os dois lados teria tornado a análise mais equilibrada, mas não teria bastado para salvar o modelo. O tamanho do erro era o problema maior, mais até do que a direção.
O que nos leva ao segundo ponto. A faixa de 95% do cenário neutro tinha cerca de 3 pontos de largura, de 49,54% a 52,57%, ou seja, o modelo admitia, com alguma folga, um erro de até 1,5 ponto para cada lado. O erro real foi de 2,85. As faixas foram obtidas por simulação, combinando a incerteza de cada componente com um termo de erro comum a todos. O problema é que esse termo comum era pequeno e na prática, o modelo tratava a maior parte da incerteza como se viesse de fontes independentes, que tendem a se compensar. Como vimos, não foi o caso. As pesquisas erraram juntas porque todas dependiam, em última instância, das mesmas entrevistas e dos mesmos métodos de coleta.
Um modelo que agrega pesquisas precisa admitir explicitamente que o conjunto inteiro pode errar por 2 ou 3 pontos na mesma direção. A forma correta de calibrar esse termo é usar o histórico de erros das pesquisas em eleições anteriores e não um valor escolhido a priori. É a principal correção que eu faria.
O terceiro ponto é que a âncora do primeiro turno protegia menos do que eu supunha, uma vez que a camada de transferência foi a que mais errou (+3,30 pp). Eu a considerava parcialmente protegida dos erros das pesquisas por estar ancorada no voto real do primeiro turno. Foi por isso, aliás, que o teste de viés lhe aplicava apenas metade de qualquer erro comum.
Embora a âncora seja sólida, o resultado do primeiro turno é fato, as taxas de migração aplicadas sobre ela vinham das próprias pesquisas, mais exatamente dos cruzamentos que perguntam aos eleitores de Cury, Renan e Caiado em quem votariam no segundo turno. Essas taxas herdaram os vieses das pesquisas e acrescentaram um problema próprio, serem estimadas em subamostras pequenas, com margens de erro muito maiores do que as das pesquisas como um todo.
O resultado mostra o tamanho da distância. Numa conta simplificada, a camada de transferência implicava que os votos em disputa se dividiriam aproximadamente em 57% para Flávio e 43% para Lula. Nos números oficiais, Lula ficou com 73,6% do ganho líquido de votos entre os dois turnos, como detalho a seguir. Esse dado é líquido e mistura migração com comparecimento, mas a diferença é grande demais para ser só isso.
Também houve uma escolha minha que vale registrar. O conjunto de transferências combinava cinco institutos e as leituras mais favoráveis a Lula, como a da Palver para os eleitores de Cury (64% a 32%), acabaram diluídas pela média. Além disso, mantive na camada de transferência os cruzamentos da Quaest de 14 de outubro, mesmo depois de o instituto divulgar uma rodada mais recente, em 21 de outubro, em que os eleitores de Cury apareciam indo 48% para Lula e 33% para Flávio. Não é óbvio que a troca teria mudado muito o resultado da camada, porque na mesma rodada os eleitores de Renan e Caiado se moveram em direção a Flávio. É possível que os sinais que apontavam para Lula estivessem nos dados, mas a estrutura do modelo os suavizou.
O último ponto vai na direção certa, mas com intensidade insuficiente. A abstenção caiu de 21,08% no primeiro turno para cerca de 19,2% no segundo, e brancos e nulos também diminuíram. No total, o segundo turno teve cerca de 4,8 milhões de votos válidos a mais do que o primeiro. O modelo expandido existia justamente para captar esse efeito. As pesquisas indicavam que quem não havia votado no primeiro turno pendia levemente para Lula e, por isso, essa camada puxava a estimativa em direção a ele. Foi o componente que menos errou. Mas, por cautela, eu o construí de forma conservadora, supondo que só uma parte desse grupo voltaria às urnas e lhe dei apenas 15% do peso. A direção estava certa, mas a magnitude não. Dessa forma, o comparecimento foi tratado com timidez.
De onde veio a vitória
Os números oficiais do TSE permitem reconstruir o caminho entre os dois turnos.
| 1º turno | 2º turno | Variação | |
| Lula | 53.879.538 | 64.256.232 | +10.376.694 |
| Flávio Bolsonaro | 56.104.503 | 59.826.041 | +3.721.538 |
| Demais candidatos | 9.316.747 | — | −9.316.747 |
| Votos válidos | 119.300.788 | 124.082.273 | +4.781.485 |
| Diferença entre os finalistas | Flávio +2.224.965 | Lula +4.430.191 |
Tabela 2: Distribuição dos votos de primeiro e segundo turnos.
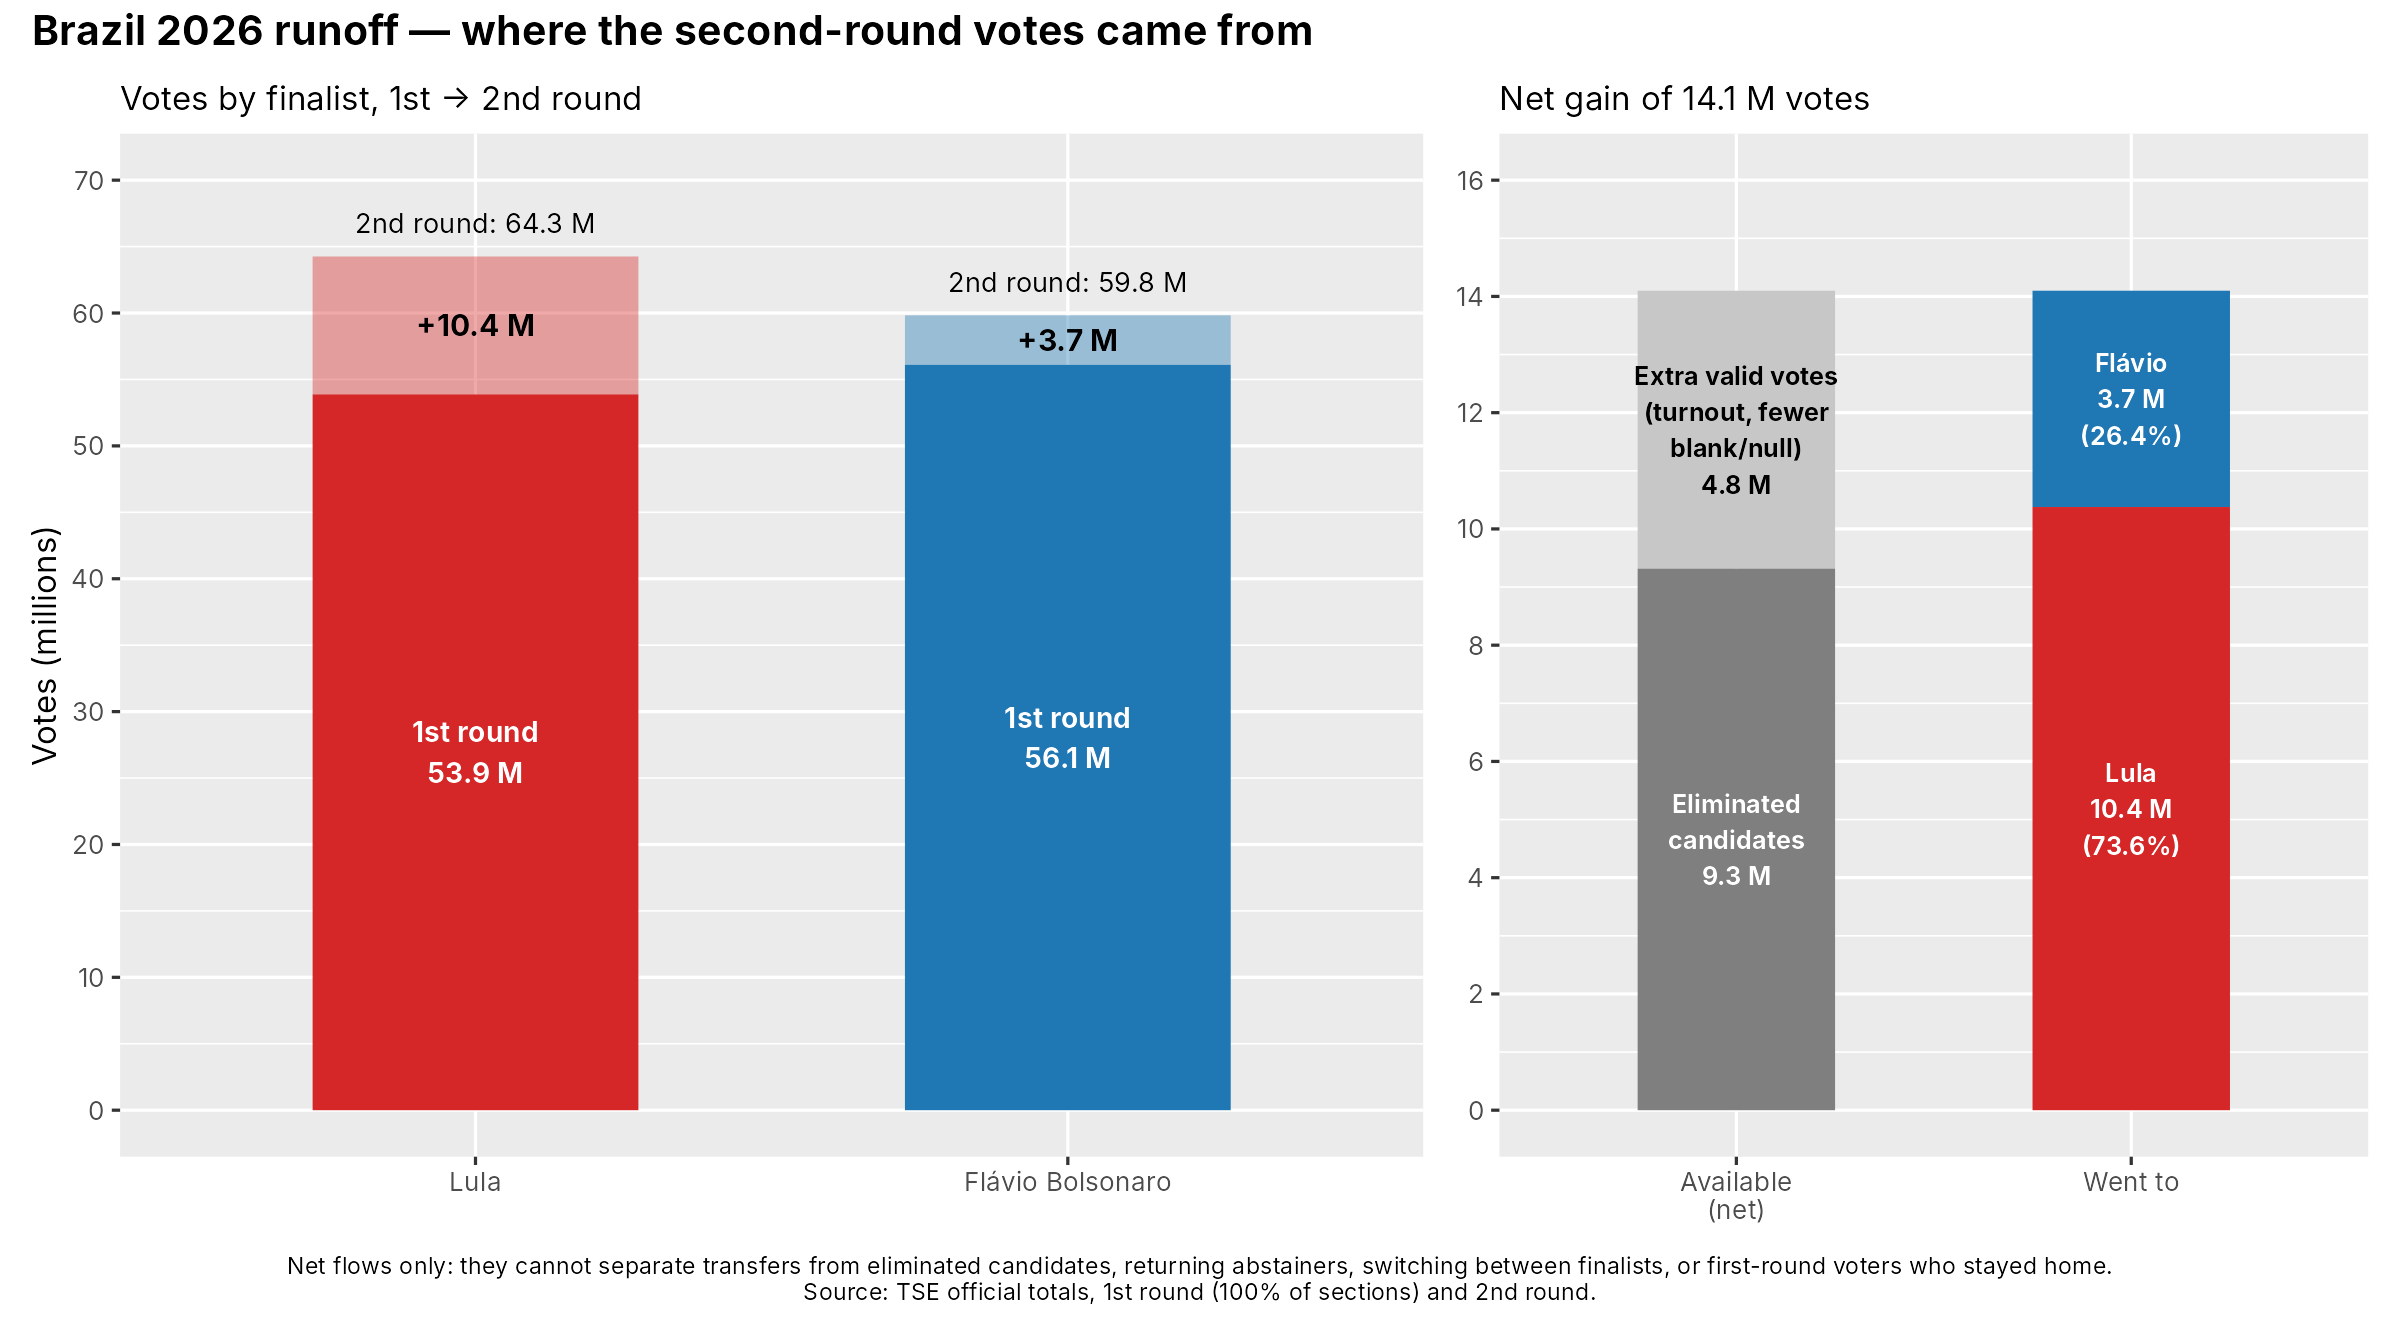
Figura 3: À esquerda, os votos de cada finalista no primeiro e no segundo turno. À direita, de onde vieram os 14,1 milhões de votos que os dois ganharam entre os turnos e para quem foram. Gráfico em inglês.
Entre um turno e outro, os dois finalistas somaram juntos 14,1 milhões de votos a mais. Esse total vem de duas fontes, os 9,3 milhões de votos que, no primeiro turno, foram para os candidatos eliminados, sobretudo Augusto Cury (3,4 milhões), Renan Santos (2,7 milhões) e Ronaldo Caiado (2,6 milhões); e os 4,8 milhões de votos válidos a mais no segundo turno, resultado da queda da abstenção (cerca de 3 milhões de pessoas a mais foram votar) e da redução de brancos e nulos (cerca de 1,9 milhão a menos).
Desse total, Lula ficou com 10,4 milhões, ou 73,6%, e Flávio com 3,7 milhões, ou 26,4%. Foi isso que transformou uma desvantagem de 2,2 milhões de votos no primeiro turno em uma vitória por 4,4 milhões no segundo, uma virada de 6,7 milhões de votos.
É preciso um certo cuidado na leitura. Esses são fluxos líquidos, ou seja, mostram o saldo final de cada candidato, mas não quem exatamente votou em quem. Por trás do mesmo saldo podem estar movimentos muito diferentes como eleitores de Cury, Renan e Caiado escolhendo um dos finalistas; pessoas que não votaram no primeiro turno e votaram no segundo; eleitores que trocaram de finalista entre os turnos; e eleitores dos finalistas que votaram no primeiro turno e não voltaram no segundo.
Os dados agregados não permitem separar esses efeitos, mas permitem um exercício útil. Suponha, para simplificar, que nenhum eleitor dos finalistas tenha trocado de lado ou deixado de votar. Nesse caso, mesmo que todos os 4,8 milhões de novos votos válidos tivessem ido para Lula, ele ainda precisaria ter conquistado cerca de 60% dos votos dos candidatos eliminados. Agora, se os novos eleitores tivessem se dividido como as pesquisas indicavam para quem não votou no primeiro turno (levemente a favor de Lula), ele precisaria ter conquistado cerca de 84% dos votos dos eliminados.
Antes da eleição, as pesquisas sugeriam o contrário, ou seja, uma divisão desses votos favorável a Flávio, algo próximo de 57% a 43% na conta simplificada do modelo. Nenhum dos cenários acima é compatível com isso.
Sobram, portanto, duas explicações possíveis, que não se excluem. Ou os eleitores dos candidatos eliminados migraram para Lula em uma proporção muito maior do que as pesquisas captaram, ou houve movimento entre os próprios eleitores dos finalistas. Isso significa que parte de quem votou em Flávio no primeiro turno mudou de voto ou ficou em casa no segundo. O mais provável é uma combinação das duas. Em qualquer caso, houve um movimento em direção a Lula que nenhuma pesquisa registrou.
O que as pesquisas não viram
Por que um movimento de alguns pontos em direção a Lula passou despercebido por todas as pesquisas? O que segue é a minha leitura, não uma conclusão demonstrada. Os dados disponíveis não permitem medir o peso de cada hipótese, e, como comentei acima, é provável que mais de uma tenha atuado ao mesmo tempo.
A primeira hipótese é a de que parte do eleitorado decidiu, ou mudou de ideia, depois das últimas pesquisas. O trabalho de campo das pesquisas finais terminou em 23 e 24 de outubro, um ou dois dias antes da votação. Qualquer movimento ocorrido depois disso simplesmente não poderia aparecer nos números.
Minha leitura é que a postura de Flávio nos debates pode ter pesado. Mas há uma ressalva importante, se o efeito dos debates tivesse se manifestado logo depois deles, as pesquisas seguintes deveriam tê-lo captado. Para que essa hipótese explique o erro, o efeito precisaria ter amadurecido tarde, nos últimos dias, quando muitos eleitores costumam consolidar o voto.
Episódios envolvendo apoiadores também podem ter contribuído. No sábado, véspera da eleição, um homem negro apareceu acorrentado, vestido com referências ao PT, durante um ato de campanha de Flávio na Barra da Tijuca. Os envolvidos alegaram tratar-se de uma “sátira” e pediram desculpas (O Globo). No domingo, uma eleitora fez uma saudação nazista para um homem judeu após votar no Colégio Santo Inácio, no Rio, e o caso foi registrado na polícia (UOL).
Os dois episódios têm alcance diferente. O primeiro viralizou nas redes entre a noite de sábado e a manhã de domingo, antes que a maioria dos eleitores votasse. O segundo aconteceu durante a própria votação, quando boa parte do eleitorado já tinha votado, e dificilmente mudou muitos votos. Nenhum dos dois, isoladamente, explica um deslocamento de quase três pontos. Fazem mais sentido como parte de um clima de fim de campanha do que como causa única.
A segunda hipótese é a de que o problema não foi o eleitor mudar, mas as pesquisas não o alcançarem. Antes da eleição, especialistas do setor alertaram que o eleitorado de direita poderia estar sub-representado nas amostras, por recusar entrevistas, morar em áreas de difícil acesso ou ser menos alcançável por telefone. O resultado sugere que, se houve um problema de representação, ele funcionou no sentido oposto. Quem ficou sub-representado, ou menos disposto a declarar o voto, foi uma parte do eleitorado de Lula. Isso é coerente com o padrão observado na Tabela 1. O erro foi praticamente o mesmo em institutos com métodos diferentes, sejam presenciais, telefônicos ou online. Um problema comum de não resposta afetaria todos eles da mesma forma, algo que uma mudança de método de um instituto isolado não explicaria.
A terceira hipótese é a do comparecimento diferencial. Cerca de 3 milhões de pessoas a mais foram votar no segundo turno. Embora as pesquisas entrevistem eleitores aptos, não sabem com precisão quem de fato irá às urnas. Se os eleitores que voltaram a votar pendiam mais para Lula do que as pesquisas indicavam, ou se parte dos eleitores de Flávio no primeiro turno deixou de votar no segundo, o resultado se desloca sem que as intenções de voto medidas estejam erradas. Como vimos, a camada do modelo dedicada a esse efeito foi justamente a que menos errou.
Como testar essas hipóteses? Nenhuma dessas explicações pode ser confirmada apenas com os totais nacionais. Mas elas deixam rastros diferentes, que podem ser investigados:
- os resultados por seção eleitoral permitem verificar se a virada foi maior onde a abstenção caiu mais (o que reforçaria a hipótese do comparecimento) ou onde Cury, Renan e Caiado tiveram mais votos (o que apontaria para a migração);
- pesquisas pós-eleitorais, que perguntam em quem a pessoa votou e quando decidiu, ajudam a separar a mudança tardia do problema de amostragem;
- a comparação entre institutos e métodos, quando os relatórios completos forem divulgados, pode indicar se algum modo de coleta errou menos.
É um trabalho que pode ser feito quando os dados detalhados estiverem disponíveis.
O que eu mudaria
Um modelo que erra só é útil se o erro ensinar alguma coisa, de forma que vale explorar alguns caminhos. A primeira mudança é a mais simples: o teste de viés comum precisa ser simétrico por padrão, com os mesmos cenários para a subestimação de cada candidato. A hipótese que circula no debate público pode orientar qual lado recebe mais atenção no texto, mas não deve decidir quais contas são feitas. Se eu tivesse publicado os dois sentidos antes da eleição, os leitores teriam visto que um erro de apenas 1,33 ponto a favor de Lula bastaria para inverter a estimativa central. Essa informação estava ao alcance do modelo e ficou de fora por uma escolha minha.
A segunda mudança diz respeito ao tamanho da incerteza. O termo que representa a possibilidade de todas as pesquisas errarem juntas não deveria ser escolhido a priori, mas estimado a partir dos erros das pesquisas em eleições anteriores. Ele também deveria admitir erros grandes com mais frequência do que uma distribuição normal admite, porque é assim que os erros de pesquisa costumam se comportar. Na maior parte do tempo são pequenos, mas de vez em quando são grandes e afetam todos os institutos ao mesmo tempo. Na prática, isso alargaria as faixas. Uma faixa larga que contém o resultado é mais útil do que uma faixa estreita que transmite uma precisão que o modelo não tinha.
A terceira mudança é tratar a camada de transferência pelo que ela realmente é, um dado de pesquisa. Ela deveria receber a exposição integral a qualquer viés comum e não apenas metade, porque as taxas de migração vêm das mesmas entrevistas que produzem as intenções de voto. Também precisaria levar em conta o tamanho das subamostras, dando menos peso a cruzamentos estimados com poucos entrevistados e propagando essa incerteza até as faixas finais. A divergência entre institutos deveria ser preservada, em vez de diluída numa média. Por exemplo, quando cinco institutos discordam fortemente sobre os eleitores de Cury, essa discordância é informação sobre a incerteza e deveria alargar as faixas em vez de desaparecer. Por coerência, a regra que já valia para as pesquisas principais, segundo a qual uma rodada nova de um instituto substitui a anterior, deveria valer também para os cruzamentos.
A quarta mudança é dar ao comparecimento o espaço que ele merece. Em vez de um ajuste conservador com peso pequeno, o modelo deveria trabalhar com cenários explícitos de abstenção (estável, em queda moderada e em queda forte), cada um com uma estimativa da composição política de quem volta a votar. A queda de quase dois pontos na abstenção entre os turnos não foi um evento extraordinário e o modelo deveria tê-la tratado como uma possibilidade central, não marginal.
Há ainda duas mudanças de menor escala. Uma é estimar o viés próprio de cada instituto. O piso metodológico limitava a influência de pesquisas isoladas, mas não identificava se algum instituto tendia sistematicamente para um lado, e com o histórico desta e de outras eleições é possível medir esses desvios e corrigi-los antes da agregação. A outra é de apresentação. Mesmo cercado de ressalvas, um número como “51,06%” chama mais atenção do que qualquer faixa. Na próxima vez, a faixa viria primeiro e a estimativa central depois.
Nem tudo, porém, precisa mudar. Algumas decisões se mostraram corretas e continuam valendo, como converter todas as pesquisas para votos válidos, substituir rodadas antigas de um mesmo instituto em vez de acumulá-las, limitar o peso de amostras muito grandes e separar com clareza o que é evidência, o que é premissa e o que é teste de sensibilidade. Acima de tudo, vale manter a decisão de publicar as premissas de forma aberta. Foi essa transparência que permitiu, agora, identificar com precisão onde o modelo falhou.
Para fechar
Este modelo nasceu de uma pergunta simples, o que se ganha ao juntar as peças, em vez de ler cada pesquisa isoladamente? A resposta que o resultado deu é menos confortável do que eu esperava. Juntar as peças reduz o ruído de cada fonte, mas não protege contra um erro que todas compartilham. Quando as pesquisas erram juntas, um agregador bem construído erra junto com elas e com mais convicção.
Há uma ironia nisso. Na véspera da eleição, fiz um exercício a pedido de conhecidos para descobrir o que seria preciso para Lula vencer e a conclusão foi que nenhum movimento extremo bastaria sozinho, mas sim uma combinação de movimentos moderados na mesma direção. Entre esses movimentos estavam um erro comum das pesquisas e uma migração dos eleitores dos candidatos derrotados muito mais favorável a Lula do que os cruzamentos indicavam. Foi mais ou menos o que aconteceu, só que com uma intensidade maior do que eu considerava plausível. O modelo tinha o mapa dos caminhos possíveis e subestimou a distância que a realidade estava disposta a percorrer.
Mas prefiro um erro bem documentado a um acerto por sorte. Se o modelo tivesse acertado o vencedor com as mesmas falhas de estrutura, eu teria aprendido menos, e provavelmente as repetiria na próxima eleição. Como errou fora da sua própria margem, ficou claro onde ele precisa mudar: no tamanho da incerteza, na simetria dos testes, no tratamento das transferências e no peso dado ao comparecimento.
Agradeço a quem acompanhou as atualizações ao longo da última semana de campanha. O texto original continua no ar, sem alterações, para quem quiser comparar o que foi dito antes com o que aconteceu depois.
Fonte: TSE, totalização do primeiro turno (100% das seções) e do segundo turno. Os números de abstenção e de brancos e nulos do segundo turno são aproximados, porque o TSE os divulgou de forma arredondada.


Deixe um comentário