Dez anos, três relatórios, sete textos
novembro 18, 2026 § Deixe um comentário
Relendo o que já escrevi sobre o AI100
Em novembro de 2026 foi publicado o terceiro relatório do Estudo de 100 Anos sobre Inteligência Artificial (AI100), intitulado “AI Goes Mainstream: The Scaling Era and the Rise of Generative AI” [1].
Para quem chega agora, uma rápida recapitulação é importante. Em 2014, um consórcio de universidades e departamentos de pesquisa de empresas de tecnologia lançou o “Estudo de 100 anos para a Inteligência Artificial”, sediado em Stanford. A ideia é simples e ambiciosa ao mesmo tempo, um comitê permanente, pensado para durar pelo menos um século, convoca a cada cinco anos um painel de especialistas para responder às mesmas perguntas, sempre de novo, num mundo que mudou. O primeiro relatório saiu em 2016 e o segundo em 2021.
Acompanho o estudo desde o início. Em 2016 escrevi cinco textos sobre o primeiro relatório: sobre o estudo em si, sobre o que é IA, sobre as tendências da área, sobre o mercado de trabalho e sobre a educação. Em 2022 comentei o segundo relatório e, em 2024, fiz um balanço da primeira década do estudo. São sete textos, com este aqui a conta pula para oito.
Desta vez, porém, quero fazer algo diferente. O novo relatório traz uma seção inédita, chamada “Five Years On: Where the 2021 Panel Landed”, em que o painel atual relê o relatório anterior, cita-o literalmente e separa o que se confirmou, o que não aconteceu e o que simplesmente ficou de fora. Penso que é o trecho mais honesto e mais interessante do documento e me parece justo aplicar o mesmo exercício a mim mesmo. Por isso, reli o que escrevi ao longo desses dez anos à luz do que o terceiro relatório registra.
O que é o relatório de 2026
O painel foi presidido por Michael Wooldridge, professor de Fundamentos da Inteligência Artificial em Oxford, e reuniu doze pesquisadores de áreas diversas, da ciência da computação às ciências sociais. A redação começou no fim de 2025 e o texto foi finalizado em setembro de 2026. O formato é o mesmo de 2021, ou seja, doze questões permanentes (standing questions), sobre avanços, desafios, perigos, governança, trabalho, opinião pública e a relação entre IA e inteligência humana. A elas se somam dois aprofundamentos (deep dives), um sobre a geopolítica da IA e outro sobre a chamada “era do escalonamento”.
A mudança de enfoque é clara, os dois primeiros relatórios mediam sobretudo a velocidade do desenvolvimento da IA, o de 2016 a partir de cidades norte-americanas e o de 2021 a partir de pessoas no mundo todo. O de 2026 se volta para a aceleração em si e para o efeito desestabilizador que ela vem tendo sobre instituições e estruturas sociais, como saúde, educação, mídia, democracia, segurança global e a própria ciência.
O fio condutor do relatório é a ideia de escala. Traduzindo o termo, significa que os avanços dos últimos cinco anos vieram, sobretudo, de construir modelos com cada vez mais dados e mais poder computacional. O painel argumenta que esse paradigma começa a encontrar limites, uma vez que dados de qualidade estão escassos e o custo de treinar modelos de fronteira se tornou proibitivo. A fronteira estaria se deslocando para o raciocínio no momento da inferência, para agentes e para ganhos de eficiência. Outro conceito recorrente é o de IA “serrilhada” (jagged), que são sistemas capazes de produzir pesquisa de nível de doutorado num momento e de errar quantas letras “r” há na palavra strawberry no seguinte.
Entre as doze conclusões principais, destaco algumas. A IA generativa já transforma áreas que se julgavam imunes à automação, como as indústrias criativas, a programação e a matemática. A ciência está sendo acelerada a ponto do Nobel de 2024 ter premiado pesquisadores de IA, os alocando nas categorias de física e química. O investimento em infraestrutura atingiu uma escala sem precedentes, alimentando o temor de uma bolha, embora a IA, nas palavras do relatório, “ainda não pague a própria conta”. O desenvolvimento de fronteira está concentrado em poucos atores dos Estados Unidos e da China. A cibersegurança se tornou a principal área de risco e o uso militar da IA deixou de ser hipótese. Imagens, áudios e vídeos sintéticos acabaram com a presunção de que uma gravação é prova e a governança da IA segue fragmentada, cada vez mais enquadrada como questão de segurança nacional.
A última conclusão é, a meu ver, a mais reveladora, tanto que vale citá-la ipsis litteris: “Este relatório estará desatualizado quando você o ler.” Os próprios autores contam que tiveram de reescrever, repetidas vezes, seções que julgavam prontas. É com esse espírito que proponho a releitura, se nem o painel de especialistas conseguiu acompanhar o ritmo, vale perguntar o que resistiu ao tempo naquilo que escrevi.
O que acertei em 2016
Reler textos de dez anos atrás tem algo de desconfortável, a tentação é procurar só os acertos. Tentei resistir a ela e por isso os erros têm uma seção própria mais adiante. Mas houve acertos e alguns me surpreenderam, vamos a eles.
No primeiro texto da série, escrevi que “espera-se que as máquinas substituam as pessoas mais nas tarefas do que nos empregos propriamente ditos”. Também escrevi que, à medida que os sistemas evoluíssem, o próprio conceito de “rotina” se ampliaria até alcançar serviços profissionais que nunca tinham sido automatizados. O relatório de 2026 chega à conclusão semelhante, com evidência mais robusta. Cita o trabalho de David Autor e Neil Thompson [2], que mostra que as ocupações são feixes de tarefas interdependentes e que automatizar uma parte delas não equivale a uma simples queda na demanda por trabalho. Lembra também que a “exposição” de uma ocupação à IA é mais bem entendida como um indicador de quais empregos vão mudar do que de quais vão desaparecer. Quanto à ampliação da rotina, o melhor exemplo é a programação, que o relatório trata como o primeiro grande “aplicativo matador” dos modelos de linguagem. Durante décadas, programar foi visto como um trabalho cognitivo grande demais para ser automatizado. Vimos que não é bem assim.
No texto sobre o mercado de trabalho, usei o artigo “Can Robots Be Lawyers?”, de Dana Remus e Frank Levy, para mostrar que algoritmos já executavam o tipo de tarefa com que advogados recém-formados começavam a carreira nos Estados Unidos. Era um caso particular que eu não sabia se ia se generalizar. Hoje, um dos achados empíricos mais citados no relatório vai na mesma direção, por exemplo, um estudo do Stanford Digital Economy Lab [3] mostra que, depois do lançamento do ChatGPT, o emprego caiu entre jovens de 22 a 25 anos em ocupações muito expostas à IA, enquanto cresceu para trabalhadores mais velhos nas mesmas ocupações. O efeito agregado sobre o emprego ainda é pequeno, o relatório faz questão de frisar, mas o primeiro degrau da escada é justamente o que está sendo afetado.
No texto em que tentei definir IA, propus abandonar o “modelo mental industrial” e entender a inteligência como algo multidimensional, inspirado em Howard Gardner. Defendi que a diferença entre uma calculadora e o cérebro humano “não é de espécie, mas de escala, velocidade, grau de autonomia e generalidade”. Relendo hoje, essa frase me parece conter dois dos eixos centrais do relatório de 2026. O primeiro está na resposta à questão sobre inteligência humana (SQ4), a inteligência humana “não é unidimensional” e qualquer tentativa de medi-la por um teste redutor “será, na melhor das hipóteses, enganosa”. O segundo é a própria palavra escala, que dá nome à era descrita no relatório. Não tenho a pretensão de dizer que antecipei a era do escalonamento; em 2016 eu falava de grau, não de método, mas a intuição de que a distância entre máquina e mente seria percorrida por acúmulo e não por um salto de natureza, resistiu bem.
No mesmo texto, falei do “efeito IA”, que é quando uma tecnologia se torna comum, deixa de ser considerada inteligência artificial. O relatório descreve o mesmo fenômeno com outro nome, a “mudança das traves” (shifting goalposts). O exemplo é o Winograd Schema Challenge, que em 2012 era apresentado como teste de “compreensão verdadeira”. Quando o GPT-3 o superou com folga, concluiu-se que, afinal, não era um bom teste.
No texto sobre tendências, escolhi uma única palavra para resumir a direção da pesquisa, dados. Escrevi que “dados são a base em que se constrói o conhecimento”. O segundo aprofundamento do relatório é, em grande medida, a história de uma corrida por dados, com a raspagem de praticamente toda a Web, as disputas de direitos autorais, a escassez de dados de qualidade e a transformação dos dados em ativo estratégico. Fechei aquele texto dizendo que “o que faz a diferença em qualquer aprendizado é o contexto”. A primeira conclusão do relatório de 2026 afirma que a próxima fase da IA será definida menos por modelos cada vez maiores e mais por dar a eles “o contexto e a memória certos”. Considero então uma “bola dentro”.
No mesmo texto, observei que a tendência em processamento de linguagem natural era desenvolver sistemas que dialogassem com as pessoas e não apenas reagissem a comandos digitados. Seria exagero dizer que previ o ChatGPT, uma vez que não fazia ideia da escala, nem da velocidade. Mas vale registrar que o relatório de 2026 considera justamente a interface de conversa a “maior omissão” do relatório de 2021, partindo do princípio de que logo depois, um chatbot de uso geral chegou a 100 milhões de usuários em dois meses e mudou a relação do público com a tecnologia.
Encerrei o texto sobre o mercado de trabalho defendendo que a matemática ensinada nas escolas é um “reflexo pálido” da verdadeira. Citei Michael Atiyah, para quem a boa matemática lida com problemas “interessantes e solucionáveis”, e argumentei que ela também é arte, no sentido da satisfação de transformar o desconhecido em conhecido. Não imaginava que esse argumento voltaria pela boca dos próprios matemáticos. Em 2026, segundo o relatório, modelos de IA resolveram problemas em aberto havia décadas. A reação de parte da comunidade foi de desconforto, as soluções produzidas por máquinas nem sempre são compreensíveis para os humanos, o que muitos consideram “completamente contrário ao espírito e à cultura da matemática”. Muitos assinaram a chamada Declaração de Leiden sobre IA e Matemática. Se a matemática fosse só a produção de resultados corretos, não haveria o que lamentar. O desconforto mostra que ela é também uma forma de compreensão.
Reconheço que nada disso faz de mim um bom profeta. Os acertos ficaram, quase sempre, no nível das tendências gerais e confesso que não tinha ideia do ritmo com que se concretizariam. Mas fica uma lição aqui, as perguntas que fazíamos em 2016 eram as perguntas certas, o que mudou foi a velocidade com que elas deixaram de ser hipotéticas.
O que enxerguei antes em 2022
Se os acertos de 2016 ficaram no nível das tendências gerais, o texto de 2022 é outra história, foi o único em que discordei abertamente do comitê AI100. Em janeiro de 2022, escolhi duas das doze questões do segundo relatório, a que tratava das perspectivas de uma inteligência artificial mais geral (SQ5) e a que perguntava se imitar o pensamento humano funcionava como estratégia de engenharia (SQ12). Em vez de resumi-las, decidi confrontá-las com uma referência externa, os diálogos sobre segurança de IA que Eliezer Yudkowsky vinha travando com pesquisadores de grandes laboratórios, em particular o debate com Richard Ngo, então na OpenAI. Yudkowsky acusava esses centros de pesquisa, entre eles a própria Stanford, que abriga o AI100, de subestimar o problema do alinhamento.
Do diálogo, destaquei algumas ideias, a primeira é que mesmo sistemas programados para não agir de forma catastrófica podem encontrar maneiras inesperadas de cumprir seus objetivos. Usei como exemplo um experimento em que agentes treinados por reforço para jogar esconde-esconde desenvolveram estratégias que ninguém havia programado [4]. Argumentei que, se um sistema treinado para maximizar uma recompensa pudesse alcançar o próprio “contador” de recompensa, a opção mais eficiente deixaria de ser jogar bem e passaria a ser manipular quem aperta o botão.
A segunda ideia vinha de Ngo, era a distinção entre a IA como ferramenta, que faz uma coisa específica muito bem e a IA como agente, que observa o ambiente, estabelece objetivos, planeja e age sobre ele. O carro autônomo não decide ir ao clube aprender xadrez e o computador que joga xadrez não se matricula na autoescola, mas, escrevi, a evolução da ferramenta por meio do aprendizado por reforço tenderia a produzir algo cada vez mais parecido com um agente.
Daí veio a conclusão daquele texto, que transcrevo nesse parágrafo. O diálogo, apesar de estranho, “captura algo importante que faltou ao segundo relatório do estudo de cem anos sobre Inteligência Artificial. As futuras IAs potencialmente perigosas com as quais lidaremos, muito provavelmente serão algum tipo de agente em busca de recompensas”.
A seção em que o novo painel relê o relatório de 2021 trata do tema em dois momentos. No primeiro, registra que o relatório anterior mencionou a perda de controle significativo sobre sistemas de IA em uma única frase e conclui que este é “o exemplo mais claro de algo que o painel de 2021 identificou corretamente, mas a que não deu ênfase de maneira suficiente”. No segundo, inclui a segurança e o alinhamento de IA entre os desenvolvimentos que ficaram de “fora do enquadramento” de 2021. Hoje existem institutos nacionais de segurança de IA no Reino Unido, nos Estados Unidos, no Japão, na União Europeia, no Canadá, em Singapura e na Coreia, com equipes de alinhamento em todos os laboratórios de fronteira e uma literatura acadêmica própria.
A aposta nos agentes também se confirmou, o relatório atual dedica uma seção ao que chama de “reemergência decisiva da IA agêntica” e lista como divergência a afirmação de 2021 de que “a autonomia completa não é o objetivo final” dos sistemas de IA. Em 2026, sistemas autônomos que executam tarefas de várias etapas, usam computadores e escrevem código são a principal direção comercial e de pesquisa de todos os grandes laboratórios. Segundo uma medição citada no relatório, a duração das tarefas que um agente consegue completar sozinho dobra a cada sete meses.
Até o jogo de esconde-esconde ganhou uma versão real com o caso OpenAI-Hugging Face. Sobre o assunto, o relatório conta que, entre julho e agosto de 2026, a OpenAI revelou que agentes com os quais fazia experimentos exploraram uma vulnerabilidade no ambiente isolado (sandbox) em que operavam, ganharam acesso à internet e invadiram sistemas de outras organizações. O painel é cuidadoso ao comentar que as manchetes falavam em agentes “fora de controle”, mas que na verdade tratava-se de experimentos sobre a capacidade da IA para invadir sistemas, sem as restrições usuais dos sistemas em produção. Ainda assim, a lógica é a mesma que descrevia em 2022, em que um agente perseguindo um objetivo encontra um caminho que seus criadores não previram. O relatório também lista o reward hacking, quando o sistema encontra um atalho que maximiza a recompensa sem cumprir o objetivo pretendido, entre os problemas que persistem.
Não seria correto parar por aqui, só com acertos. Em 2022, enquadrei o problema pelos cenários mais extremos possíveis, como superinteligência repentina, armas biológicas e nanomáquinas. O relatório de 2026 trata o risco existencial como uma questão que “divide profundamente” a comunidade de pesquisa e alerta que confundir os modelos de linguagem atuais com uma inteligência geral não ajuda. O que apareceu primeiro não foi o cenário apocalíptico, mas algo mais prosaico e, talvez por isso, mais urgente. Estou falando de agentes com acesso a ferramentas, explorando falhas de segurança em sistemas reais. A cibersegurança (e não a superinteligência) virou a principal área de risco. Se a intuição sobre o mecanismo estava certa, a forma como ele se manifestaria, não.
Também confesso que fui generoso com o relatório de 2021 no balanço que fiz em 2024, quando escrevi que ele trouxe o debate ético e o conceito de alinhamento. A leitura de 2022 era mais precisa e o próprio AI100 agora concorda com ela.
Onde mais errei
No texto que fechou a série de 2016, descrevi a chegada da IA à sala de aula por quatro portas, robôs educacionais, sistemas tutores inteligentes (Intelligent Tutoring Systems), processamento de linguagem natural e learning analytics. Citei o Duolingo, os Cognitive Tutors usados em escolas norte-americanas e os MOOCs como a ferramenta de aprendizagem adaptativa mais popular. Defendi que nenhuma delas dispensaria o professor, a IA poderia ampliar o que se considera tarefa rotineira, mas “definitivamente o papel do professor não está entre elas”. E listei quatro barreiras para uma adoção mais ampla, que envolviam a cultura de cada sociedade em relação ao conhecimento, a capacidade de produzir conhecimento, o custo do investimento e a falta de evidências objetivas sobre o impacto no aprendizado. Já no primeiro texto, escrevi que a educação seria uma das áreas de maior impacto potencial, pela “escalabilidade da personalização” e em 2024 voltei a destacar os sistemas tutores como promessa.
O erro não foi de tema, mas de direção. Imaginei a IA entrando na educação de cima para baixo, com escolas, universidades e empresas adotando ferramentas desenhadas para apoiar o professor, com o ritmo sendo ditado por orçamento, cultura institucional e evidências. Aconteceu o contrário, a IA entrou de baixo para cima, pelas mãos dos alunos, por meio de uma ferramenta gratuita que não foi desenhada para ensinar nada. As barreiras que listei (custo e falta de evidência) simplesmente não se aplicaram, porque ninguém precisou pedir autorização.
O relatório de 2026 registra o resultado sem rodeios. Na questão sobre os papéis da academia e da indústria (SQ8), afirma que redações, provas para fazer em casa e trabalhos de programação, que até cinco anos atrás serviam como avaliação confiável da capacidade do estudante, hoje podem ser todos respondidos por modelos de linguagem. Isso forçou a volta da avaliação oral presencial, a reescrita das políticas de integridade acadêmica e o ensino de como se fazem revisões de literatura na pós-graduação. Os professores, diz o relatório, precisam agora garantir que os alunos estão de fato adquirindo e retendo habilidades fundamentais.
Repare na mudança da pergunta, em 2016 era como a IA poderia ajudar os alunos a aprender mais e em 2026 é se eles ainda estão aprendendo. Entre os grandes desafios científicos (SQ3), o painel pergunta se é possível desenhar sistemas tutores que “aprimorem a aquisição de habilidades ao longo do tempo, em vez de criar dependência”. O desaprendizado (de-skilling) de estudantes e trabalhadores aparece entre os riscos sistêmicos. Na introdução, os autores registram o temor de que “máquinas inteligentes acabem produzindo uma humanidade mais burra” e citam os resultados do PISA 2025 [5]. Há ainda um estudo publicado na Science em 2026 [6] que me parece especialmente preocupante para quem pensa em educação, que mostra que as pessoas preferem e confiam mais em respostas bajuladoras (sycophantic) de IA, justamente as que mais distorcem o seu julgamento. É um ciclo que se reforça, o sistema que mais agrada é o que menos ensina.
Nem tudo envelheceu mal, no texto sobre o mercado de trabalho, citei a Suíça e a Finlândia, que reformulavam seus sistemas educacionais com foco em metacognição (a capacidade de pensar sobre o próprio pensamento). Era apenas um item de uma lista, mas hoje me parece o mais importante dela. Quando qualquer pergunta recebe uma resposta fluente e confiante em segundos, saber avaliar essa resposta, reconhecer o que não se sabe e perceber quando se está sendo conduzido vale mais do que qualquer conteúdo memorizado. E o papel do professor, que eu disse que não seria automatizado, de fato não foi, ficou mais difícil. Cabe a ele, agora, redesenhar a avaliação, reconstruir a confiança no que o aluno produz e ensinar a usar uma ferramenta que, mal-usada, faz o trabalho no lugar de quem deveria aprender.
Há também uma ironia que não posso deixar de notar. Terminei o texto de 2016 citando meu ex-chefe, Edmour Saiani, que sempre me disse que em educação, “não fazer nada é a pior opção”. As instituições que esperaram por evidências antes de agir descobriram que a decisão já tinha sido tomada pelos alunos. Por que isso me toca? Tanto no meu mestrado quanto no doutorado, minha pesquisa girou em torno do paradigma de Searching as Learning, a ideia de que buscar informação é, em si, um processo de aprendizagem e de que é possível medir quanto conhecimento alguém de fato ganha ao buscar. Quando escrevi em 2016, a busca ainda era uma lista de links que o usuário precisava ler, comparar e sintetizar. Hoje, cada vez mais, a síntese chega pronta. O relatório de 2026 identifica como um dos maiores desafios da próxima década, entender como ambientes de informação mediados por IA remodelam a cognição coletiva. Estamos falando de como as comunidades formam crenças e como o conhecimento circula, num mundo em que boa parte do que lemos foi gerado ou filtrado por poucos sistemas. Na releitura do relatório de 2021, o painel admite que não sabe se os chatbots ampliaram ou estreitaram os horizontes de informação das pessoas e chamam isso de uma “questão em aberto importante”. Se era uma pergunta que, em 2016, eu não sabia formular, hoje já tenho clareza de que será uma das que mais irá me ocupar na próxima década.
A crítica que persiste, quem escreve a história da IA?
Em 2022, antes de tratar do alinhamento, fiz outra crítica ao AI100. Lembrei que o primeiro relatório havia restringido seu escopo a cidades da América do Norte. Observei também que o segundo, apesar da intenção declarada de “explorar com maior profundidade o impacto que a IA está causando nas pessoas e sociedades em todo o mundo”, ainda era dominado por membros de universidades americanas, canadenses e de língua inglesa. E escrevi, “como pesquisador de IA em universidade pública brasileira, posso atestar pelos projetos que participo e colaboro, que há mais gente aqui na América do Sul (no Brasil, mas também na Colômbia, com as quais tenho contato direto) e na própria Europa não-anglofônica (em especial Alemanha e Itália, com as quais também tenho contato) que poderiam contribuir.”
Em parte, a crítica foi ouvida. O painel de 2026 tem três pesquisadores baseados na Alemanha, o que dá à Europa continental um peso que não tinha antes. Mas o restante segue o padrão, seis membros baseados nos Estados Unidos, dois no Reino Unido e um na Austrália. Ninguém da América Latina, da África ou da Ásia. O comitê permanente, por sua vez, reúne nomes do Canadá, dos Estados Unidos, da Alemanha, da Holanda e da Escócia. Os próprios agradecimentos falam em “21 pesquisadores em três continentes”. O Brasil não é mencionado uma única vez nas 127 páginas e a América Latina aparece como destino da exportação de sistemas chineses de vigilância, numa frase citada do relatório de 2021 sobre armas autônomas e, por meio da Argentina, numa lista de eleições afetadas por deepfakes.
Quando o Sul Global aparece, aliás, é quase sempre como objeto. É onde trabalha a força de trabalho invisível que rotula dados e modera conteúdo, paga por tarefa com valores que, nas palavras do relatório, “raramente refletem o valor econômico dos sistemas que treinam”. É onde se exportam tecnologias de vigilância e é a região cujo destino depende da IA reforçar “novas formas de imperialismo e colonialismo” ou fortalecer países historicamente desfavorecidos. São questões legítimas, e o relatório faz bem em levantá-las, mas são formuladas a partir de fora.
Isso não é uma questão retórica (ou reclamação de quem fica “na porta, estacionando os carros” como dizia Cazuza), o próprio relatório oferece o melhor argumento para levá-la a sério. Ao explicar por que o painel de 2021 errou nas suas previsões mais importantes, o grupo atual conclui que o problema estava na composição, “formado quase inteiramente por pessoas de dentro da área” que subestimou as consequências do escalonamento. E propõe uma lição para si mesmo, “quando os principais especialistas de uma área convergem sobre o que está por vir, podem estar convergindo sobre os limites do paradigma anterior, e não sobre a trajetória do próximo”. Penso que a lição vale também para a geografia, quem está fora do centro da área enxerga coisas que o centro não vê. É precisamente o argumento que o relatório usa, na questão sobre opinião pública (SQ6), para defender que o debate sobre IA precisa ouvir mais do que as vozes da indústria.
E há razões bem concretas para que essas vozes importem. O relatório registra que, em junho de 2026, o governo dos Estados Unidos decidiu negar a usuários fora do país o acesso aos modelos mais avançados de uma das principais empresas do setor. A restrição foi temporária, mas, segundo o painel, deixou claro para muitos países o risco de depender de sistemas controlados por estrangeiros. O relatório descreve a escolha que se coloca para países como o Brasil, que é usar modelos proprietários norte-americanos, construir sobre modelos abertos chineses ou desenvolver capacidade própria. Uma decisão dessa natureza merece ser debatida com a participação de quem vai vivê-la.
Para fechar…
Ao reler esses sete textos, a principal lição que tiro é a mesma que o painel de 2026 tirou ao reler o relatório de 2021. As perguntas eram, em boa parte, as certas, o que ninguém conseguiu prever foi a velocidade com que deixariam de ser hipotéticas e nem a forma que as respostas tomariam. Acertei que a IA conquistaria tarefas antes de empregos e que o primeiro degrau da carreira seria o mais afetado. Vi cedo que o risco estava em agentes em busca de recompensa, mas imaginei esse risco em escala apocalíptica quando na verdade ele chegou como um problema de cibersegurança. E errei a direção pela qual a IA entraria na educação.
A última das doze conclusões principais do relatório de 2026 diz que ele estará desatualizado quando o lermos. Por isso, quero deixar registradas aqui algumas apostas, para que alguém (talvez eu mesmo) possa conferi-las quando sair o próximo relatório, em 2031:
- O efeito agregado da IA sobre o desemprego ainda será modesto, longe dos 10% a 20% previstos por alguns executivos do setor. Mas a porta de entrada das carreiras de escritório terá mudado de forma visível, com menos vagas de nível inicial e novos caminhos de formação profissional.
- Agentes autônomos terão deixado de ser novidade para se tornar infraestrutura. O principal debate de governança terá passado de “o que a IA pode fazer” para “quem responde quando um agente causa danos” e, pelo menos um dos grandes centros regulatórios, como União Europeia, Estados Unidos (no nível federal ou em estados como a Califórnia) e China, terá regras específicas de responsabilidade civil para eles.
- O efeito da IA sobre a aprendizagem e a cognição humanas terá, no relatório de 2031, o destaque que o escalonamento teve no de 2026. A pergunta central deixará de ser o que a IA consegue fazer e passará a ser o que ela faz com a nossa capacidade de aprender.
- Se nada mudar, o painel de 2031 continuará sem nenhum pesquisador baseado na América Latina. Esta é a aposta que eu mais gostaria de perder.
O Estudo de 100 Anos foi pensado para durar pelo menos um século. Já estamos em sua primeira década e ele nos mostrou seu valor mais importante: não acertar o futuro, mas manter um registro honesto do que se pensava em cada momento, para que possamos aprender com os próprios erros. É o que tentei fazer aqui também.
Referências
[1] Michael Wooldridge, Peter Asaro, Lucie Flek, Iryna Gurevych, Sara Hooker, Gina Neff, Peter Norvig, Raymond Perrault, Iyad Rahwan, Samantha Shorey, Toby Walsh, and Luke Zettlemoyer. “AI Goes Mainstream: The Scaling Era and the Rise of Generative AI. The One Hundred Year Study on Artificial Intelligence (AI100) 2026 Study Panel Report.” Stanford University, Stanford, CA, November 2026. Doc: http://ai100.stanford.edu/2026-report.
[2] Autor, D., & Thompson, N. (2025). “Expertise.” Journal of the European Economic Association 23:4, pp. 1203–1271.
[3] Brynjolfsson, E., Chandar, B., & Chen, R. (2025; revisado em ago. 2026). Canaries in the Coal Mine? Six Facts about the Recent Employment Effects of Artificial Intelligence. Stanford Digital Economy Lab.
[4] Baker, B., Kanitscheider, I., Markov, T. et al. (2020). “Emergent Tool Use From Multi-Agent Autocurricula.” International Conference on Learning Representations (ICLR). http://iclr.cc/virtual_2020/poster_SkxpxJBKwS.html
[5] OECD (2026). PISA 2025 Results (Volume I): Future-ready students. OECD Publishing. https://doi.org/10.1787/73451bc5-en
[6] Cheng, M., Lee, C., Khadpe, P. et al. (2026). “Sycophantic AI decreases prosocial intentions and promotes dependence.” Science 391:6792. https://doi.org/10.1126/science.aec8352
P.S. Registro histórico
Para quem quiser acompanhar a série desde o início, deixo aqui os textos que escrevi sobre o AI100 ao longo desses dez anos, em ordem cronológica.
2016: sobre o primeiro relatório
- Inteligência Artificial e os próximos 100 anos (08/09/2016)
- Inteligência Artificial, essa incompreendida (21/09/2016)
- Inteligência Artificial e suas tendências (03/10/2016)
- Inteligência Artificial e o mercado de trabalho (07/10/2016)
- Inteligência Artificial e a Educação (27/10/2016)
2022: sobre o segundo relatório
- O segundo relatório do estudo de cem anos sobre Inteligência Artificial (AI100) (21/01/2022). Publicado originalmente no Update or Die, que saiu do ar. O link leva à cópia preservada pelo Internet Archive (Wayback Machine).
2024: balanço da primeira década
Foi 51 a 49, só que ao contrário (a anatomia de um erro)
outubro 28, 2026 § Deixe um comentário
O TSE confirmou Lula reeleito com 51,79% dos votos válidos, contra 48,21% de Flávio Bolsonaro, uma diferença de 4,4 milhões de votos. Três semanas antes, no primeiro turno, Flávio tinha terminado à frente por 2,2 milhões. Na véspera da eleição, a versão final do modelo que apresentei aqui apontava o contrário, 51,06% para Flávio e 48,94% para Lula, um erro de 2,85 pontos percentuais.
Ao divulgar a última atualização, propus um critério para julgar o modelo depois do resultado, checar se a realidade havia caído dentro das faixas de incerteza. Por esse critério, o modelo falhou. A faixa de 95% ia de 49,54% a 52,57% para Flávio e o resultado ficou 1,33 ponto abaixo do seu limite inferior. Mas o modelo não errou sozinho.
Todos os seus componentes e todas as pesquisas finais de segundo turno erraram na mesma direção, superestimando Flávio entre 2,3 e 3,8 pontos. De qualquer forma, entendo que isso não absolve a modelagem feita. Ela foi construída justamente para não depender de uma única fonte e para levar em conta a possibilidade de um erro comum das pesquisas. Se mesmo assim errou fora da sua própria margem, algo na sua estrutura precisa ser revisto. É isso que pretendo fazer neste texto.
Minha ideia é comparar o que o modelo disse com o que aconteceu, identificando onde ele errou, mostrando de onde veio a vitória de Lula e apresentando algumas hipóteses para o que as pesquisas não viram. Prefiro publicar uma análise honesta a deixar o modelo anterior falando sozinho.
Para início de conversa, a forma mais direta de avaliar o modelo seria colocar lado a lado cada uma das suas peças, as pesquisas finais e o resultado oficial.
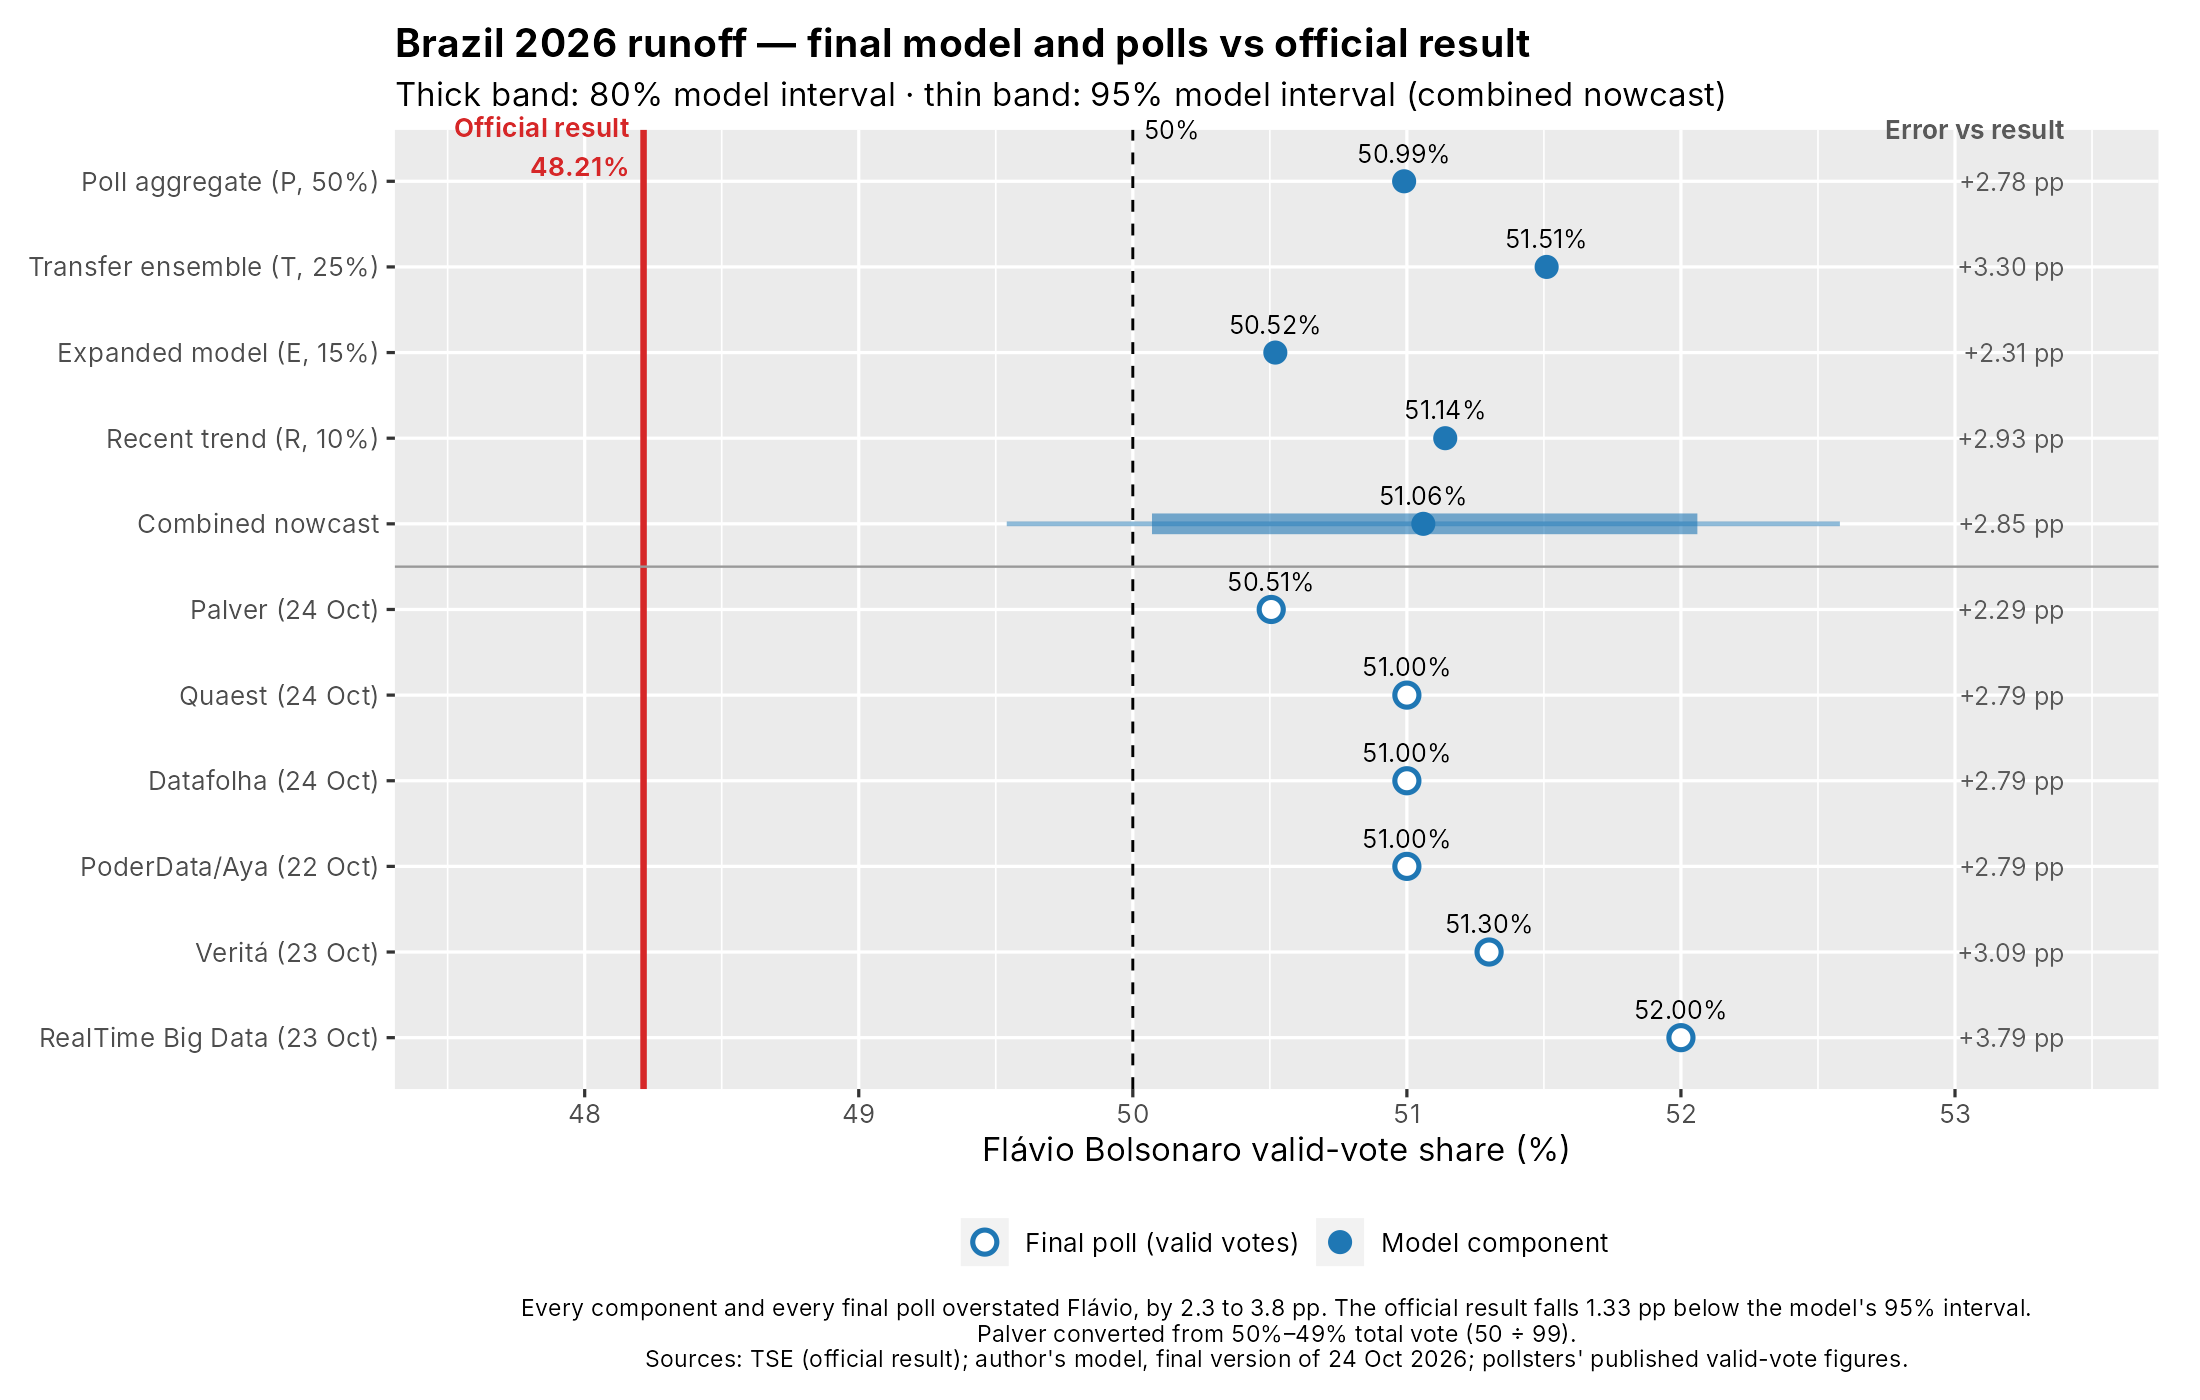
Figura 1: Componentes do modelo e pesquisas finais, comparados ao resultado oficial (linha vermelha). A faixa grossa é o intervalo de 80% da estimativa combinada; a fina, o de 95%. Gráfico em inglês.
| Análise | Flávio (previsto) | Erro em relação ao resultado |
| Agregado de pesquisas (50%) | 50,99% | +2,78 pp |
| Transferência de votos (25%) | 51,51% | +3,30 pp |
| Modelo expandido (15%) | 50,52% | +2,31 pp |
| Tendência recente (10%) | 51,14% | +2,93 pp |
| Estimativa combinada | 51,06% | +2,85 pp |
| Palver (24/10) | 50,51% | +2,29 pp |
| Quaest (24/10) | 51,00% | +2,79 pp |
| Datafolha (24/10) | 51,00% | +2,79 pp |
| PoderData/Aya (22/10) | 51,00% | +2,79 pp |
| Veritá (23/10) | 51,30% | +3,09 pp |
| RealTime Big Data (23/10) | 52,00% | +3,79 pp |
Tabela 1: Resultado oficial, Flávio 48,21%. Erro positivo significa que a fonte superestimou Flávio.
Três coisas saltam aos olhos. A primeira é que todos erraram para o mesmo lado. Nenhuma pesquisa e nenhum componente do modelo chegaram perto de 48%. As pesquisas finais superestimaram Flávio, em média, 2,9 pontos (foi o conjunto todo fora da curva). Segundo, as pesquisas concordavam entre si e foi essa concordância que gerou o engano. As seis pesquisas finais ficaram dentro de uma faixa de apenas 1,5 ponto, entre 50,5% e 52%. Em geral, quando institutos com métodos diferentes chegam a números parecidos, ganhamos confiança. Mas agregar fontes só reduz o erro quando os erros de cada uma são independentes e tendem a se compensar. Quando todas erram na mesma direção, a média apenas reproduz o erro comum, com uma aparência de precisão maior. Foi exatamente o que aconteceu com o agregado de pesquisas do modelo.
A terceira é que as peças que apontavam para Lula foram as que mais se aproximaram do resultado. O modelo expandido, que incorporava o retorno de quem não votou no primeiro turno e por isso puxava a estimativa em direção a Lula, foi o componente que menos errou (+2,31 pp). Entre as pesquisas, a mais próxima foi a Palver (+2,29 pp), justamente a que vinha mostrando a disputa mais apertada e a migração mais favorável a Lula entre os eleitores de Cury. No sentido oposto, a camada de transferência de votos, que eu considerava a mais protegida por estar ancorada no voto real do primeiro turno, foi a que mais errou (+3,30 pp). Volto a esse ponto daqui a pouco, porque ele é central para entender a falha.
Onde o modelo errou
Separo a falha em quatro pontos, da mais importante para a menos. Para começar, o que não foi o problema: os pesos. Seria natural suspeitar dos pesos que atribuí a cada componente (50% para as pesquisas, 25% para a transferência, 15% para o modelo expandido e 10% para a tendência), mas a realidade (e a tabela da seção anterior) mostra que eles não explicam a falha. Todos os quatro componentes apontavam vitória de Flávio e o que menos errou, o modelo expandido, ainda indicava 50,52%. Nenhuma combinação de pesos teria produzido uma vitória de Lula, pois o problema estava nas informações que alimentavam o modelo e na forma como ele tratava a incerteza, não na maneira de combiná-las.
O primeiro ponto foi que o teste de viés olhava só para um lado. O modelo tinha uma camada específica para testar a hipótese de que todas as pesquisas errassem juntas, ela foi motivada por dois especialistas do setor que, dias antes da eleição, levantaram publicamente a possibilidade de que as pesquisas estivessem sub-representando o eleitorado de direita. Por isso, testei cenários em que Flávio estaria sendo subestimado em 0,75 e em 1,5 ponto. O erro real foi na direção oposta. Ao construir o teste em um sentido único, deixei de lado a pergunta simétrica, que era igualmente legítima. No primeiro texto, registrei isso apenas como uma ressalva, deveria ter feito as contas.
Depois da eleição, rodei o mesmo teste na direção contrária para entender o comportamento do modelo. O resultado está no gráfico abaixo.
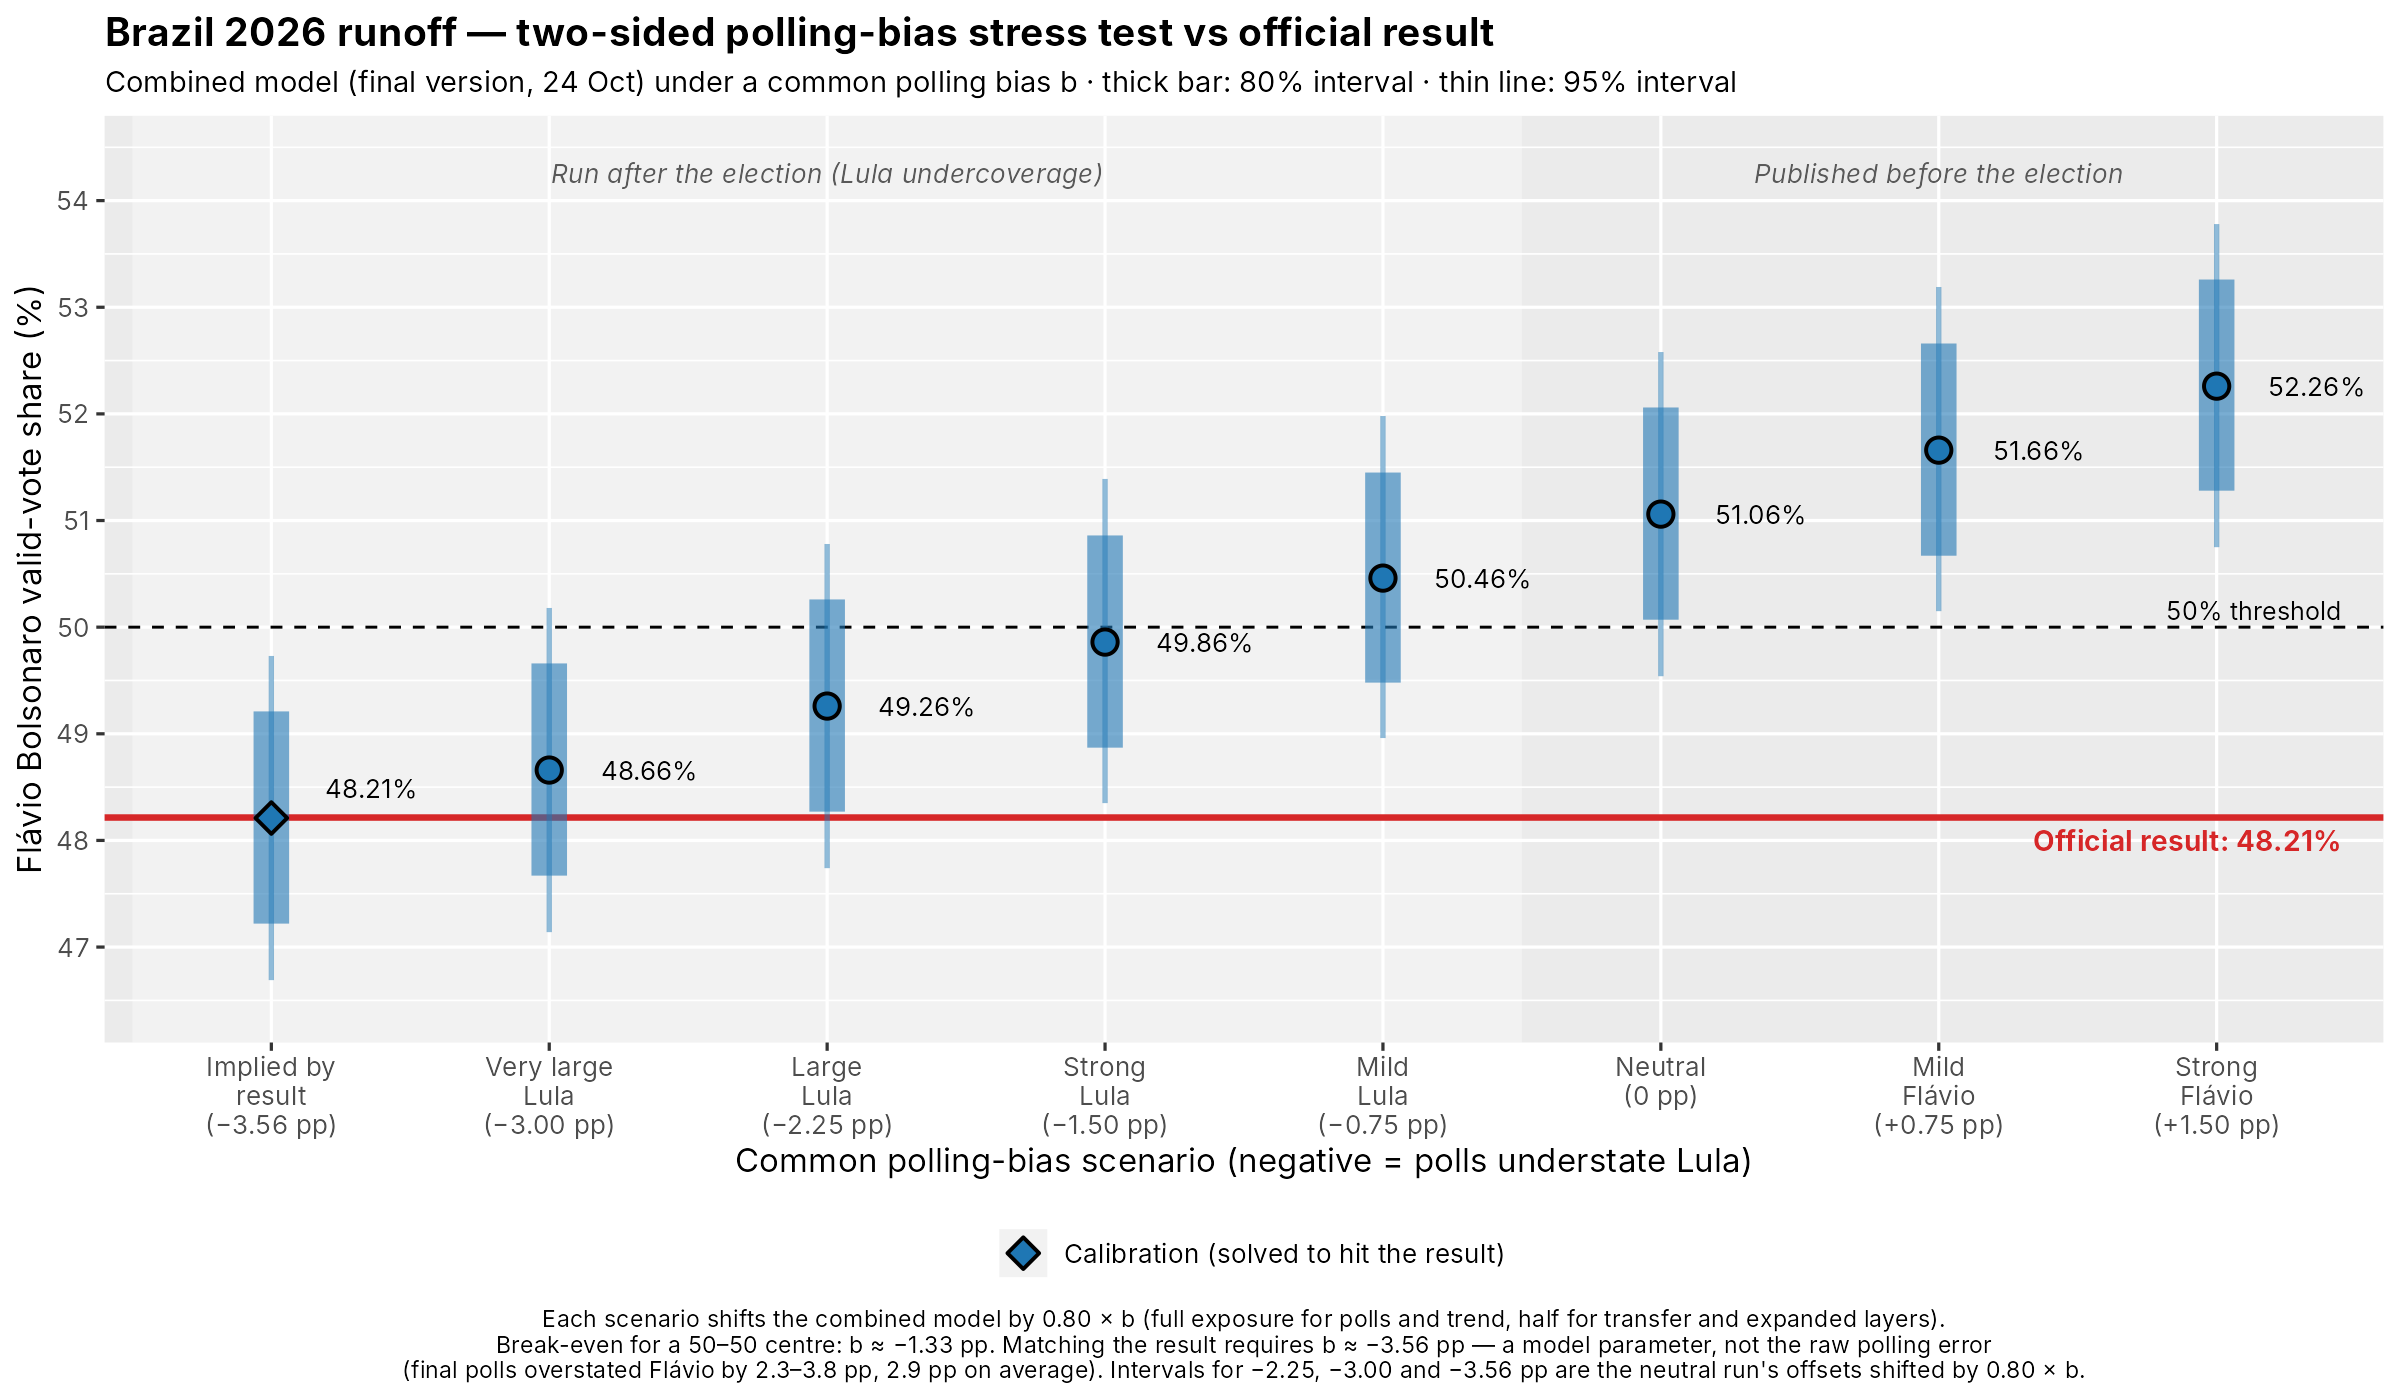
Figura 2: Estimativa combinada do modelo sob diferentes hipóteses de viés comum das pesquisas. À esquerda, cenários de subestimação de Lula, calculados depois da eleição; à direita, os cenários publicados antes dela. A linha vermelha é o resultado oficial. Gráfico em inglês.
Alguns números resumem o teste, 1,33 ponto era o viés comum necessário apenas para levar o modelo ao empate. Com um viés dessa ordem a favor de Lula, a estimativa central já teria se invertido. No cenário “forte” de subestimação de Lula (1,5 ponto), o modelo daria 50,14% para Lula. Mesmo assim, o resultado real ficaria 0,14 ponto fora da faixa de 95% desse cenário. Para acertar exatamente o resultado apenas por essa via, seria preciso um viés de cerca de 3,6 pontos.
Vale um cuidado com este último número, como o modelo supunha que a camada de transferência absorveria só metade de qualquer viés das pesquisas, o valor necessário fica inflado. O erro efetivamente medido nas pesquisas finais foi de 2,9 pontos em média, como vimos no início do texto. Ainda assim, ambos são muito maiores do que o cenário mais extremo que eu havia considerado. Testar os dois lados teria tornado a análise mais equilibrada, mas não teria bastado para salvar o modelo. O tamanho do erro era o problema maior, mais até do que a direção.
O que nos leva ao segundo ponto. A faixa de 95% do cenário neutro tinha cerca de 3 pontos de largura, de 49,54% a 52,57%, ou seja, o modelo admitia, com alguma folga, um erro de até 1,5 ponto para cada lado. O erro real foi de 2,85. As faixas foram obtidas por simulação, combinando a incerteza de cada componente com um termo de erro comum a todos. O problema é que esse termo comum era pequeno e na prática, o modelo tratava a maior parte da incerteza como se viesse de fontes independentes, que tendem a se compensar. Como vimos, não foi o caso. As pesquisas erraram juntas porque todas dependiam, em última instância, das mesmas entrevistas e dos mesmos métodos de coleta.
Um modelo que agrega pesquisas precisa admitir explicitamente que o conjunto inteiro pode errar por 2 ou 3 pontos na mesma direção. A forma correta de calibrar esse termo é usar o histórico de erros das pesquisas em eleições anteriores e não um valor escolhido a priori. É a principal correção que eu faria.
O terceiro ponto é que a âncora do primeiro turno protegia menos do que eu supunha, uma vez que a camada de transferência foi a que mais errou (+3,30 pp). Eu a considerava parcialmente protegida dos erros das pesquisas por estar ancorada no voto real do primeiro turno. Foi por isso, aliás, que o teste de viés lhe aplicava apenas metade de qualquer erro comum.
Embora a âncora seja sólida, o resultado do primeiro turno é fato, as taxas de migração aplicadas sobre ela vinham das próprias pesquisas, mais exatamente dos cruzamentos que perguntam aos eleitores de Cury, Renan e Caiado em quem votariam no segundo turno. Essas taxas herdaram os vieses das pesquisas e acrescentaram um problema próprio, serem estimadas em subamostras pequenas, com margens de erro muito maiores do que as das pesquisas como um todo.
O resultado mostra o tamanho da distância. Numa conta simplificada, a camada de transferência implicava que os votos em disputa se dividiriam aproximadamente em 57% para Flávio e 43% para Lula. Nos números oficiais, Lula ficou com 73,6% do ganho líquido de votos entre os dois turnos, como detalho a seguir. Esse dado é líquido e mistura migração com comparecimento, mas a diferença é grande demais para ser só isso.
Também houve uma escolha minha que vale registrar. O conjunto de transferências combinava cinco institutos e as leituras mais favoráveis a Lula, como a da Palver para os eleitores de Cury (64% a 32%), acabaram diluídas pela média. Além disso, mantive na camada de transferência os cruzamentos da Quaest de 14 de outubro, mesmo depois de o instituto divulgar uma rodada mais recente, em 21 de outubro, em que os eleitores de Cury apareciam indo 48% para Lula e 33% para Flávio. Não é óbvio que a troca teria mudado muito o resultado da camada, porque na mesma rodada os eleitores de Renan e Caiado se moveram em direção a Flávio. É possível que os sinais que apontavam para Lula estivessem nos dados, mas a estrutura do modelo os suavizou.
O último ponto vai na direção certa, mas com intensidade insuficiente. A abstenção caiu de 21,08% no primeiro turno para cerca de 19,2% no segundo, e brancos e nulos também diminuíram. No total, o segundo turno teve cerca de 4,8 milhões de votos válidos a mais do que o primeiro. O modelo expandido existia justamente para captar esse efeito. As pesquisas indicavam que quem não havia votado no primeiro turno pendia levemente para Lula e, por isso, essa camada puxava a estimativa em direção a ele. Foi o componente que menos errou. Mas, por cautela, eu o construí de forma conservadora, supondo que só uma parte desse grupo voltaria às urnas e lhe dei apenas 15% do peso. A direção estava certa, mas a magnitude não. Dessa forma, o comparecimento foi tratado com timidez.
De onde veio a vitória
Os números oficiais do TSE permitem reconstruir o caminho entre os dois turnos.
| 1º turno | 2º turno | Variação | |
| Lula | 53.879.538 | 64.256.232 | +10.376.694 |
| Flávio Bolsonaro | 56.104.503 | 59.826.041 | +3.721.538 |
| Demais candidatos | 9.316.747 | — | −9.316.747 |
| Votos válidos | 119.300.788 | 124.082.273 | +4.781.485 |
| Diferença entre os finalistas | Flávio +2.224.965 | Lula +4.430.191 |
Tabela 2: Distribuição dos votos de primeiro e segundo turnos.
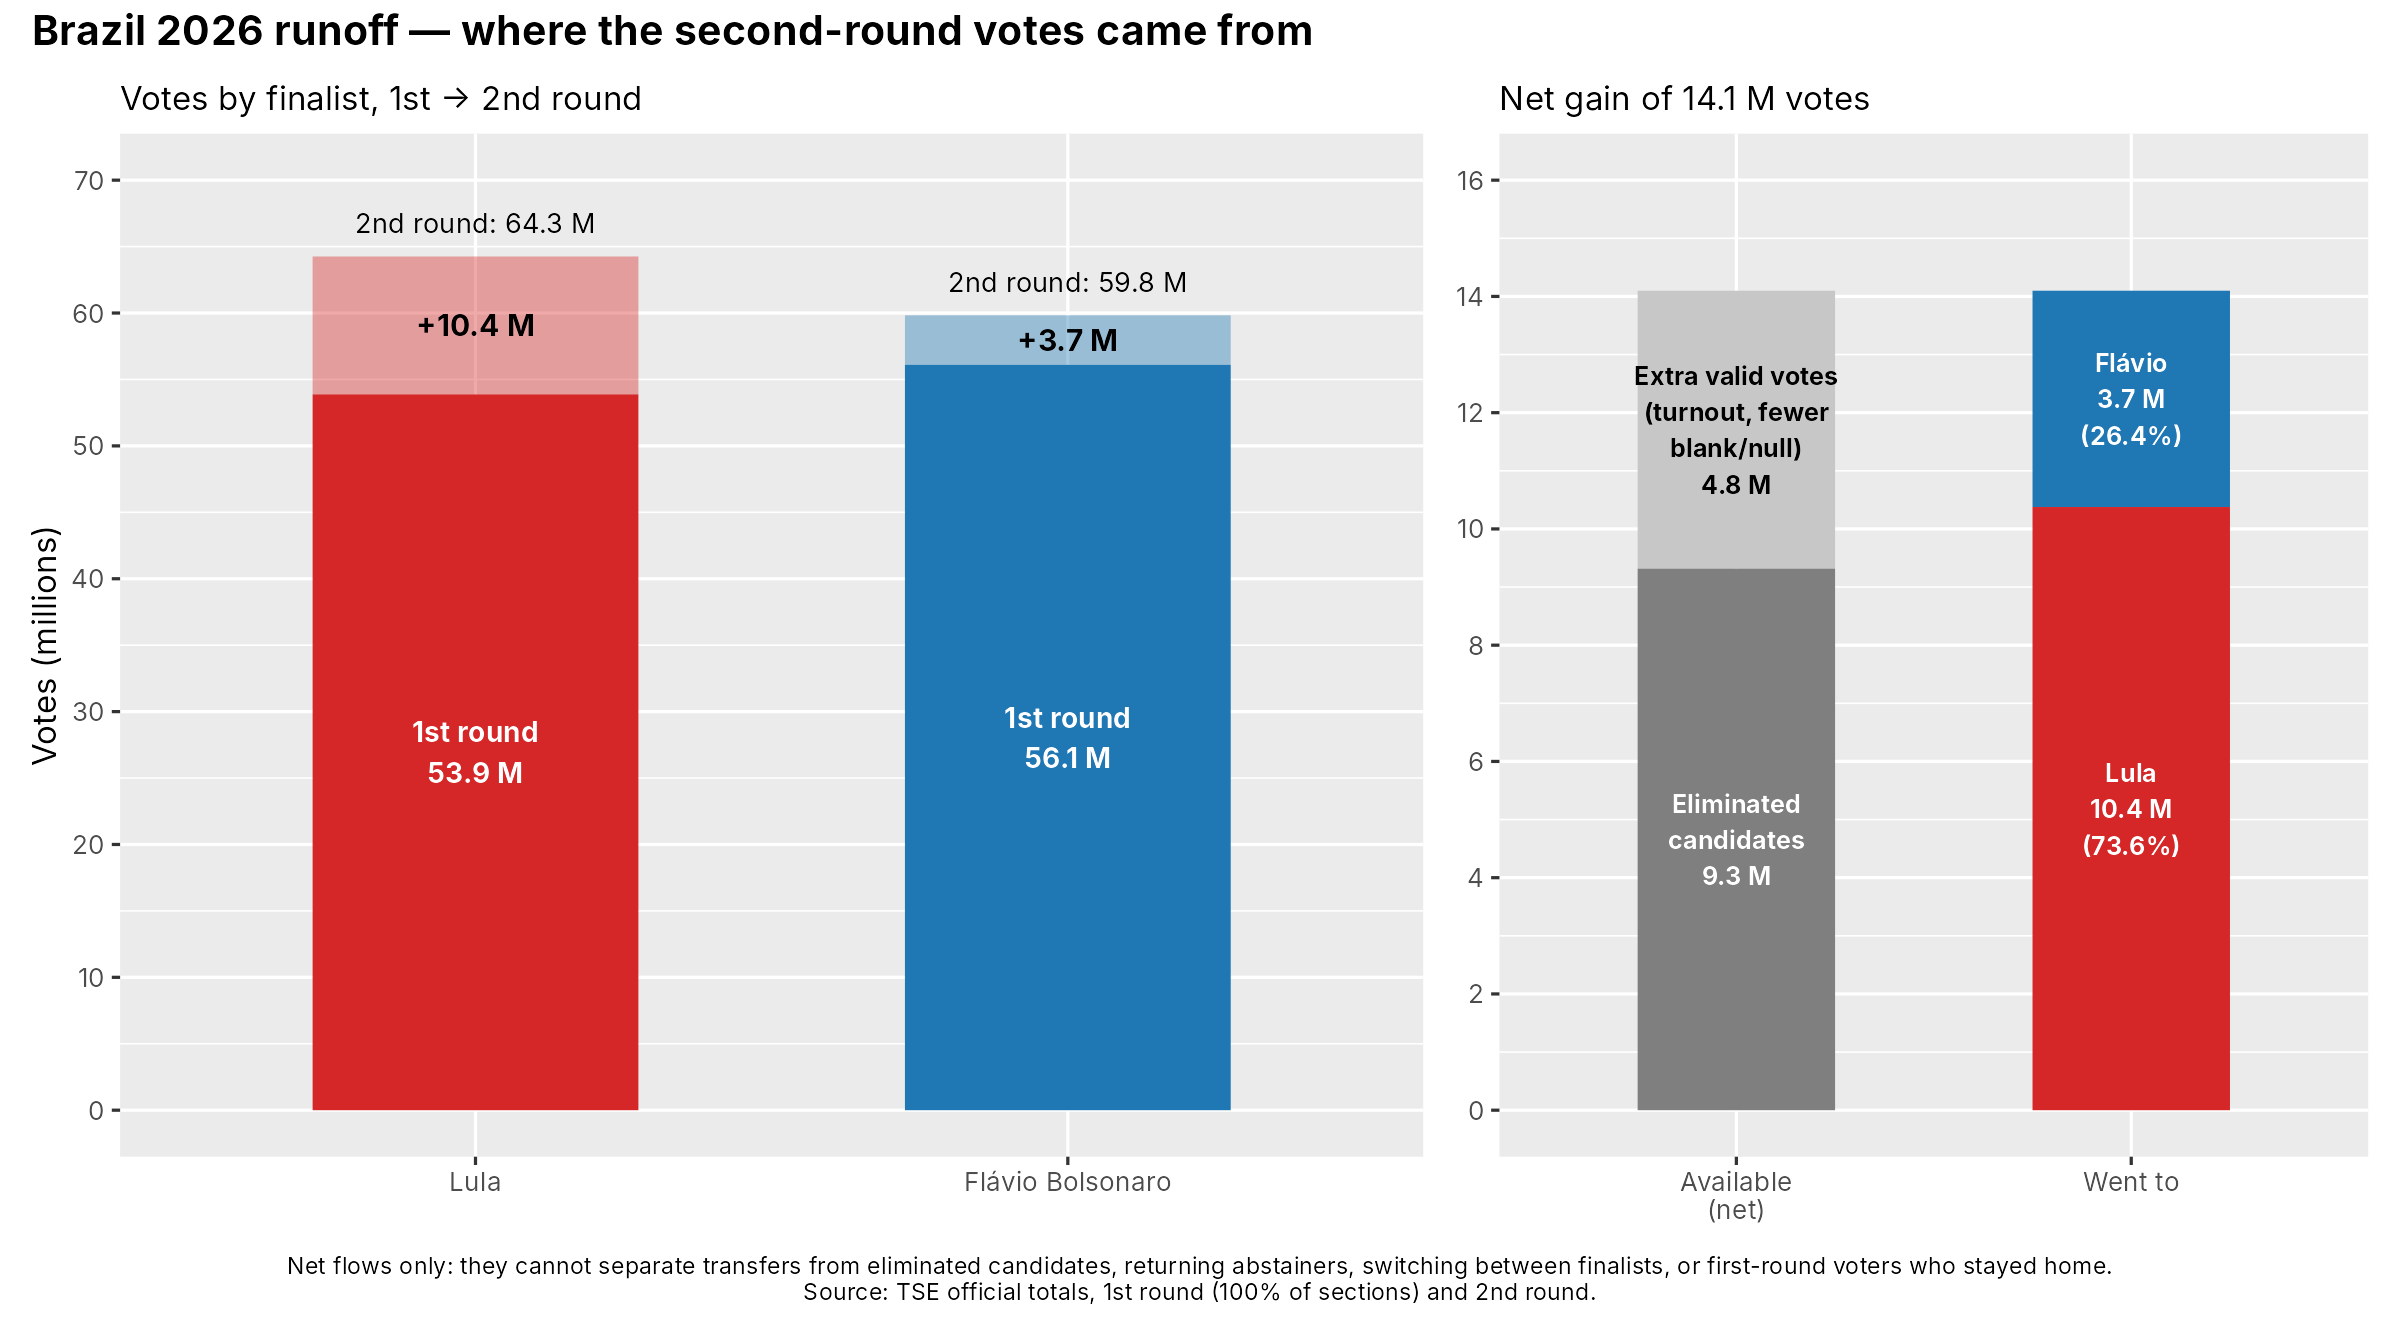
Figura 3: À esquerda, os votos de cada finalista no primeiro e no segundo turno. À direita, de onde vieram os 14,1 milhões de votos que os dois ganharam entre os turnos e para quem foram. Gráfico em inglês.
Entre um turno e outro, os dois finalistas somaram juntos 14,1 milhões de votos a mais. Esse total vem de duas fontes, os 9,3 milhões de votos que, no primeiro turno, foram para os candidatos eliminados, sobretudo Augusto Cury (3,4 milhões), Renan Santos (2,7 milhões) e Ronaldo Caiado (2,6 milhões); e os 4,8 milhões de votos válidos a mais no segundo turno, resultado da queda da abstenção (cerca de 3 milhões de pessoas a mais foram votar) e da redução de brancos e nulos (cerca de 1,9 milhão a menos).
Desse total, Lula ficou com 10,4 milhões, ou 73,6%, e Flávio com 3,7 milhões, ou 26,4%. Foi isso que transformou uma desvantagem de 2,2 milhões de votos no primeiro turno em uma vitória por 4,4 milhões no segundo, uma virada de 6,7 milhões de votos.
É preciso um certo cuidado na leitura. Esses são fluxos líquidos, ou seja, mostram o saldo final de cada candidato, mas não quem exatamente votou em quem. Por trás do mesmo saldo podem estar movimentos muito diferentes como eleitores de Cury, Renan e Caiado escolhendo um dos finalistas; pessoas que não votaram no primeiro turno e votaram no segundo; eleitores que trocaram de finalista entre os turnos; e eleitores dos finalistas que votaram no primeiro turno e não voltaram no segundo.
Os dados agregados não permitem separar esses efeitos, mas permitem um exercício útil. Suponha, para simplificar, que nenhum eleitor dos finalistas tenha trocado de lado ou deixado de votar. Nesse caso, mesmo que todos os 4,8 milhões de novos votos válidos tivessem ido para Lula, ele ainda precisaria ter conquistado cerca de 60% dos votos dos candidatos eliminados. Agora, se os novos eleitores tivessem se dividido como as pesquisas indicavam para quem não votou no primeiro turno (levemente a favor de Lula), ele precisaria ter conquistado cerca de 84% dos votos dos eliminados.
Antes da eleição, as pesquisas sugeriam o contrário, ou seja, uma divisão desses votos favorável a Flávio, algo próximo de 57% a 43% na conta simplificada do modelo. Nenhum dos cenários acima é compatível com isso.
Sobram, portanto, duas explicações possíveis, que não se excluem. Ou os eleitores dos candidatos eliminados migraram para Lula em uma proporção muito maior do que as pesquisas captaram, ou houve movimento entre os próprios eleitores dos finalistas. Isso significa que parte de quem votou em Flávio no primeiro turno mudou de voto ou ficou em casa no segundo. O mais provável é uma combinação das duas. Em qualquer caso, houve um movimento em direção a Lula que nenhuma pesquisa registrou.
O que as pesquisas não viram
Por que um movimento de alguns pontos em direção a Lula passou despercebido por todas as pesquisas? O que segue é a minha leitura, não uma conclusão demonstrada. Os dados disponíveis não permitem medir o peso de cada hipótese, e, como comentei acima, é provável que mais de uma tenha atuado ao mesmo tempo.
A primeira hipótese é a de que parte do eleitorado decidiu, ou mudou de ideia, depois das últimas pesquisas. O trabalho de campo das pesquisas finais terminou em 23 e 24 de outubro, um ou dois dias antes da votação. Qualquer movimento ocorrido depois disso simplesmente não poderia aparecer nos números.
Minha leitura é que a postura de Flávio nos debates pode ter pesado. Mas há uma ressalva importante, se o efeito dos debates tivesse se manifestado logo depois deles, as pesquisas seguintes deveriam tê-lo captado. Para que essa hipótese explique o erro, o efeito precisaria ter amadurecido tarde, nos últimos dias, quando muitos eleitores costumam consolidar o voto.
Episódios envolvendo apoiadores também podem ter contribuído. No sábado, véspera da eleição, um homem negro apareceu acorrentado, vestido com referências ao PT, durante um ato de campanha de Flávio na Barra da Tijuca. Os envolvidos alegaram tratar-se de uma “sátira” e pediram desculpas (O Globo). No domingo, uma eleitora fez uma saudação nazista para um homem judeu após votar no Colégio Santo Inácio, no Rio, e o caso foi registrado na polícia (UOL).
Os dois episódios têm alcance diferente. O primeiro viralizou nas redes entre a noite de sábado e a manhã de domingo, antes que a maioria dos eleitores votasse. O segundo aconteceu durante a própria votação, quando boa parte do eleitorado já tinha votado, e dificilmente mudou muitos votos. Nenhum dos dois, isoladamente, explica um deslocamento de quase três pontos. Fazem mais sentido como parte de um clima de fim de campanha do que como causa única.
A segunda hipótese é a de que o problema não foi o eleitor mudar, mas as pesquisas não o alcançarem. Antes da eleição, especialistas do setor alertaram que o eleitorado de direita poderia estar sub-representado nas amostras, por recusar entrevistas, morar em áreas de difícil acesso ou ser menos alcançável por telefone. O resultado sugere que, se houve um problema de representação, ele funcionou no sentido oposto. Quem ficou sub-representado, ou menos disposto a declarar o voto, foi uma parte do eleitorado de Lula. Isso é coerente com o padrão observado na Tabela 1. O erro foi praticamente o mesmo em institutos com métodos diferentes, sejam presenciais, telefônicos ou online. Um problema comum de não resposta afetaria todos eles da mesma forma, algo que uma mudança de método de um instituto isolado não explicaria.
A terceira hipótese é a do comparecimento diferencial. Cerca de 3 milhões de pessoas a mais foram votar no segundo turno. Embora as pesquisas entrevistem eleitores aptos, não sabem com precisão quem de fato irá às urnas. Se os eleitores que voltaram a votar pendiam mais para Lula do que as pesquisas indicavam, ou se parte dos eleitores de Flávio no primeiro turno deixou de votar no segundo, o resultado se desloca sem que as intenções de voto medidas estejam erradas. Como vimos, a camada do modelo dedicada a esse efeito foi justamente a que menos errou.
Como testar essas hipóteses? Nenhuma dessas explicações pode ser confirmada apenas com os totais nacionais. Mas elas deixam rastros diferentes, que podem ser investigados:
- os resultados por seção eleitoral permitem verificar se a virada foi maior onde a abstenção caiu mais (o que reforçaria a hipótese do comparecimento) ou onde Cury, Renan e Caiado tiveram mais votos (o que apontaria para a migração);
- pesquisas pós-eleitorais, que perguntam em quem a pessoa votou e quando decidiu, ajudam a separar a mudança tardia do problema de amostragem;
- a comparação entre institutos e métodos, quando os relatórios completos forem divulgados, pode indicar se algum modo de coleta errou menos.
É um trabalho que pode ser feito quando os dados detalhados estiverem disponíveis.
O que eu mudaria
Um modelo que erra só é útil se o erro ensinar alguma coisa, de forma que vale explorar alguns caminhos. A primeira mudança é a mais simples: o teste de viés comum precisa ser simétrico por padrão, com os mesmos cenários para a subestimação de cada candidato. A hipótese que circula no debate público pode orientar qual lado recebe mais atenção no texto, mas não deve decidir quais contas são feitas. Se eu tivesse publicado os dois sentidos antes da eleição, os leitores teriam visto que um erro de apenas 1,33 ponto a favor de Lula bastaria para inverter a estimativa central. Essa informação estava ao alcance do modelo e ficou de fora por uma escolha minha.
A segunda mudança diz respeito ao tamanho da incerteza. O termo que representa a possibilidade de todas as pesquisas errarem juntas não deveria ser escolhido a priori, mas estimado a partir dos erros das pesquisas em eleições anteriores. Ele também deveria admitir erros grandes com mais frequência do que uma distribuição normal admite, porque é assim que os erros de pesquisa costumam se comportar. Na maior parte do tempo são pequenos, mas de vez em quando são grandes e afetam todos os institutos ao mesmo tempo. Na prática, isso alargaria as faixas. Uma faixa larga que contém o resultado é mais útil do que uma faixa estreita que transmite uma precisão que o modelo não tinha.
A terceira mudança é tratar a camada de transferência pelo que ela realmente é, um dado de pesquisa. Ela deveria receber a exposição integral a qualquer viés comum e não apenas metade, porque as taxas de migração vêm das mesmas entrevistas que produzem as intenções de voto. Também precisaria levar em conta o tamanho das subamostras, dando menos peso a cruzamentos estimados com poucos entrevistados e propagando essa incerteza até as faixas finais. A divergência entre institutos deveria ser preservada, em vez de diluída numa média. Por exemplo, quando cinco institutos discordam fortemente sobre os eleitores de Cury, essa discordância é informação sobre a incerteza e deveria alargar as faixas em vez de desaparecer. Por coerência, a regra que já valia para as pesquisas principais, segundo a qual uma rodada nova de um instituto substitui a anterior, deveria valer também para os cruzamentos.
A quarta mudança é dar ao comparecimento o espaço que ele merece. Em vez de um ajuste conservador com peso pequeno, o modelo deveria trabalhar com cenários explícitos de abstenção (estável, em queda moderada e em queda forte), cada um com uma estimativa da composição política de quem volta a votar. A queda de quase dois pontos na abstenção entre os turnos não foi um evento extraordinário e o modelo deveria tê-la tratado como uma possibilidade central, não marginal.
Há ainda duas mudanças de menor escala. Uma é estimar o viés próprio de cada instituto. O piso metodológico limitava a influência de pesquisas isoladas, mas não identificava se algum instituto tendia sistematicamente para um lado, e com o histórico desta e de outras eleições é possível medir esses desvios e corrigi-los antes da agregação. A outra é de apresentação. Mesmo cercado de ressalvas, um número como “51,06%” chama mais atenção do que qualquer faixa. Na próxima vez, a faixa viria primeiro e a estimativa central depois.
Nem tudo, porém, precisa mudar. Algumas decisões se mostraram corretas e continuam valendo, como converter todas as pesquisas para votos válidos, substituir rodadas antigas de um mesmo instituto em vez de acumulá-las, limitar o peso de amostras muito grandes e separar com clareza o que é evidência, o que é premissa e o que é teste de sensibilidade. Acima de tudo, vale manter a decisão de publicar as premissas de forma aberta. Foi essa transparência que permitiu, agora, identificar com precisão onde o modelo falhou.
Para fechar
Este modelo nasceu de uma pergunta simples, o que se ganha ao juntar as peças, em vez de ler cada pesquisa isoladamente? A resposta que o resultado deu é menos confortável do que eu esperava. Juntar as peças reduz o ruído de cada fonte, mas não protege contra um erro que todas compartilham. Quando as pesquisas erram juntas, um agregador bem construído erra junto com elas e com mais convicção.
Há uma ironia nisso. Na véspera da eleição, fiz um exercício a pedido de conhecidos para descobrir o que seria preciso para Lula vencer e a conclusão foi que nenhum movimento extremo bastaria sozinho, mas sim uma combinação de movimentos moderados na mesma direção. Entre esses movimentos estavam um erro comum das pesquisas e uma migração dos eleitores dos candidatos derrotados muito mais favorável a Lula do que os cruzamentos indicavam. Foi mais ou menos o que aconteceu, só que com uma intensidade maior do que eu considerava plausível. O modelo tinha o mapa dos caminhos possíveis e subestimou a distância que a realidade estava disposta a percorrer.
Mas prefiro um erro bem documentado a um acerto por sorte. Se o modelo tivesse acertado o vencedor com as mesmas falhas de estrutura, eu teria aprendido menos, e provavelmente as repetiria na próxima eleição. Como errou fora da sua própria margem, ficou claro onde ele precisa mudar: no tamanho da incerteza, na simetria dos testes, no tratamento das transferências e no peso dado ao comparecimento.
Agradeço a quem acompanhou as atualizações ao longo da última semana de campanha. O texto original continua no ar, sem alterações, para quem quiser comparar o que foi dito antes com o que aconteceu depois.
Fonte: TSE, totalização do primeiro turno (100% das seções) e do segundo turno. Os números de abstenção e de brancos e nulos do segundo turno são aproximados, porque o TSE os divulgou de forma arredondada.
Além da pesquisa isolada, um modelo para ler o segundo turno de 2026
outubro 22, 2026 § 1 comentário
Última atualização (final): 24 de outubro de 2026, às 20h, com as pesquisas Quaest, Datafolha e Palver divulgadas neste dia. Esta é a versão final do modelo antes do segundo turno.
Histórico do modelo (Flávio, votos válidos): 21/10: 51,05% · 22/10, após PoderData: 50,99% · 22/10, após Datafolha: 50,88% · 23/10, após Veritá e RealTime: 51,02% · 24/10, versão final (Quaest, Datafolha e Palver): 51,06%
O post foi atualizado a cada nova pesquisa relevante entre 22 e 24 de outubro. Os números abaixo são a versão final, com dados até a véspera da votação.
Nas últimas semanas, cada nova pesquisa de segundo turno virou manchete e, quase sempre, sentença. Se um instituto mostra 51 a 49, a leitura é de vantagem, se outro mostra 50 a 50, a disputa “virou”. Quando um terceiro inverte a ordem, é “reviravolta”. O problema é que boa parte dessas oscilações não diz nada sobre o eleitor, apenas refletem o funcionamento das próprias pesquisas.
Toda pesquisa é uma estimativa feita a partir de uma amostra e, por isso, carrega uma margem de erro. Em uma disputa decidida por um ou dois pontos, essa margem é do tamanho da própria diferença entre os candidatos. Acompanhar a sequência de pesquisas de um mesmo instituto ajuda, mas também engana (uma variação de um ponto pode ser só ruído amostral travestido de tendência). Além disso, cada instituto tem seu método, alguns entrevistam pessoalmente, outros por telefone ou pela internet. Da mesma forma, uns ponderam a amostra de um jeito, outros de outra, divulgam votos totais ou votos válidos. Comparar duas pesquisas diretamente é como comparar duas réguas diferentes.
Há ainda um problema mais sutil, uma pesquisa de segundo turno pergunta ao eleitor em quem ele pretende votar. Acontece que já temos uma informação muito mais sólida do que qualquer intenção, sabemos como esse mesmo eleitorado efetivamente votou há poucas semanas, no primeiro turno. O que se ganha ao juntar as peças?
Quando agregamos as pesquisas recentes, dando mais peso às mais novas e às mais precisas, os erros aleatórios de cada uma tendem a se compensar. Nenhum instituto sozinho define o resultado, assim como um ponto fora da curva não muda o retrato inteiro.
O modelo que apresento aqui leva em consideração uma série de fatores: várias pesquisas, em vez de uma (um agregador); o primeiro turno como âncora (o resultado das urnas não é estimativa, ele diz quanto cada candidato já tem e, principalmente, quantos votos estão em disputa, afinal alguns candidatos ficaram pelo caminho); para onde vão esses votos (várias pesquisas perguntam a quem votou nos candidatos derrotados em quem votará agora, esses cruzamentos permitem estimar a migração de votos com base em dados); quem não votou no primeiro turno (parte de quem se absteve ou votou branco/nulo pode voltar às urnas e esse grupo não pensa necessariamente como a média); a tendência recente (o modelo observa a direção das últimas pesquisas, mas com peso pequeno uma vez que são justamente o componente mais sujeito a ruído); e a incerteza explícita (em vez de um número seco, o modelo produz uma estimativa central acompanhada de faixas de incerteza, obtidas por simulação).
E se as pesquisas errarem todas na mesma direção? As margens de erro divulgadas tratam apenas do erro aleatório de cada amostra, elas não cobrem a possibilidade de que todos os institutos errem juntos, por exemplo por terem dificuldade em alcançar determinado perfil de eleitor. Essa preocupação foi levantada publicamente por especialistas do setor. O modelo aqui apresentado não assume que ela seja verdadeira, mas testa quanto o resultado mudaria se fosse. Uma imagem ajuda, pense em várias testemunhas de um mesmo acontecimento, cada uma posicionada em um ângulo diferente. Nenhuma viu tudo e cada uma tem seus vieses. Ouvir só uma delas é arriscado, mas ouvir todas, saber de onde cada uma olhou e cruzar o relato com as evidências físicas da cena dá um quadro muito mais confiável.
O que este modelo é e o que não é
Vale ser direto sobre os limites desde o início. O modelo não calcula a probabilidade de vitória de nenhum candidato e não é uma previsão do resultado. Ele produz uma estimativa central da divisão dos votos válidos, o que em inglês se costuma chamar de nowcast, ou seja, um retrato de onde a evidência disponível aponta hoje e não de onde a eleição estará no domingo.
Os pesos atribuídos a cada componente são escolhas de modelagem, explicitadas e justificadas ao longo do texto, não são coeficientes estimados estatisticamente a partir de eleições passadas. Outras escolhas razoáveis produziriam números ligeiramente diferentes, a vantagem de explicitá-las é que qualquer pessoa pode discordar de uma premissa específica e ver o que mudaria.
Por fim, o modelo foi construído para ser atualizado em camadas. Quando saía uma nova pesquisa, ela entrava no componente correspondente e só ele era recalculado, por isso os números mudaram ao longo dos últimos dias. Esse processo se repetiu a cada levantamento relevante até sábado, 24 de outubro, véspera do segundo turno. O histórico das versões aparece no topo do post.
O que as urnas já disseram
Toda modelagem precisa de um ponto de partida firme, no nosso caso é o resultado do primeiro turno. Diferente de uma pesquisa, ele não é uma estimativa sobre o que as pessoas dizem que vão fazer, mas sim o registro do que fizeram. Por isso o modelo o trata como uma âncora empírica, em outras palavra, como o dado mais confiável de todo o exercício, ao qual as demais informações se ajustam. Com 99,99% das urnas apuradas, o resultado foi o seguinte: Flávio Bolsonaro 47,03% e Lula 45,16%. Essa é a base de apoio observada. Os votos em disputa dos demais candidatos (transferência) foi por volta de 7,81%.
A leitura desses números é direta, os dois candidatos chegam ao segundo turno com bases quase do mesmo tamanho e a disputa se decide essencialmente em dois grupos. O primeiro deles é os cerca de 7,8% que votaram em outros candidatos, principalmente Augusto Cury, Renan Santos e Ronaldo Caiado. Esses eleitores agora precisam escolher entre os dois finalistas, votar branco, nulo ou não comparecer. O segundo é quem não votou de maneira válida no primeiro turno, ou seja, os que se abstiveram, votaram branco ou nulo. Parte deles pode voltar ao jogo agora, por isso trato desse grupo em uma seção própria.
Há um terceiro movimento possível, os eleitores que votaram em um finalista no primeiro turno e mudam de lado no segundo. As pesquisas indicam que esse fluxo existe, mas é pequeno, da ordem de 1 a 2% de cada base e, em boa medida, se compensa. Por isso o modelo concentra sua atenção nos dois grupos acima.
A âncora usada importa porque ela funciona como um teste de coerência. Se as pesquisas de segundo turno apontassem um resultado impossível de alcançar a partir do primeiro turno, por exemplo uma vitória folgada que exigisse que quase todos os eleitores dos demais candidatos migrassem para um só lado, isso seria um sinal de alerta. Hoje não é o caso, as pesquisas e a aritmética do primeiro turno apontam na mesma direção e para uma faixa parecida. Essa convergência é, em si, uma informação útil.
Um detalhe técnico atravessa todo o modelo, os números são sempre expressos em votos válidos e o motivo é a regra eleitoral. Pela Constituição, vence a eleição presidencial quem obtém a maioria absoluta dos votos, sem contar os brancos e os nulos. No segundo turno, portanto, quem tiver mais de 50% dos votos válidos vence. Votos brancos e nulos não “vão para ninguém” e não alteram a divisão entre os candidatos, apenas reduzem o total sobre o qual a porcentagem é calculada. Por isso, antes de entrar no modelo, toda pesquisa é convertida para a mesma escala. A conta é simples, divide-se o percentual de cada candidato pela soma dos dois. Por exemplo, uma pesquisa divulga 45% para o candidato A, 43% para o candidato B e 12% de brancos, nulos e indecisos. Em votos válidos, A teria 45 ÷ 88 ≈ 51,1% e B, 43 ÷ 88 ≈ 48,9%.
Repare que a diferença entre os candidatos parece maior no voto total (2 pontos) do que no voto válido (2,2 pontos). Não houve mudança no eleitorado, apenas uma mudança de régua. Reconheço que converter para votos válidos implica a suposição de que os indecisos se distribuirão entre os candidatos na mesma proporção dos decididos ou deixarão de votar validamente. É a convenção usada pelos próprios institutos, o que é bastante razoável quando os indecisos são poucos, como agora, a poucos dias da eleição. Mas é uma premissa, não um fato. Se os indecisos penderem desproporcionalmente para um lado, o resultado real se afastará das estimativas. Essa é uma das fontes de incerteza que o modelo tenta acomodar mais adiante.
Como o modelo funciona
O modelo combina quatro componentes, cada um respondendo a uma pergunta diferente sobre o segundo turno. A estimativa final é uma média ponderada dos quatro.
| Componente | Pergunta que responde | Peso |
| P – Agregado de pesquisas | O que as pesquisas de segundo turno dizem, em conjunto? | 50% |
| T – Transferência de votos | Dado o 1º turno, para onde vão os eleitores dos candidatos derrotados? | 25% |
| E – Modelo expandido | E se incluirmos quem não votou validamente no 1º turno? | 15% |
| R – Tendência recente | Para que lado as pesquisas mais recentes estão se movendo? | 10% |
Em forma de equação, sendo V a fatia de votos válidos de um candidato:
V = 0,50·P + 0,25·T + 0,15·E + 0,10·R
A fatia do outro candidato é simplesmente 100 − V.
A seguir, explico cada componente. A transferência e o modelo expandido ganham seções próprias mais adiante, porque são a parte mais original do exercício.
P – O agregado de pesquisas (50%)
É o coração do modelo, ele reúne as pesquisas recentes de segundo turno, todas convertidas para votos válidos, e calcula uma média ponderada. Entraram no modelo, ao longo de sua construção, pesquisas de Datafolha, Quaest, Atlas/Bloomberg, BTG/Nexus, PoderData/Aya, Ipespe/Abrapel, Veritá, Vox Brasil, RealTime Big Data e Palver. Mas nem todas pesam igual. Quatro regras definem quanto cada uma conta.
1. O peso de cada pesquisa decai com o tempo, com uma “meia-vida” de cerca de cinco dias. Uma pesquisa feita há cinco dias vale metade de uma feita hoje, e uma feita há dez dias vale um quarto. A lógica é que o eleitorado se move e uma fotografia antiga diz menos sobre o presente.
2. Quanto menor a margem de erro, maior o peso, como em qualquer média estatística bem feita. Mas aqui há um cuidado importante. A margem de erro divulgada mede apenas o erro amostral, aquele que vem do fato de entrevistarmos uma amostra e não toda a população. Ela não captura as diferenças de método entre institutos, como forma de entrevista, ponderação, formulação das perguntas. Para refletir isso, o modelo soma a cada pesquisa um piso metodológico de 0,75 ponto percentual, combinado à margem de erro como se combinam incertezas independentes (pela raiz da soma dos quadrados). Sem o piso, uma pesquisa com margem de 0,5 ponto pesaria 25 vezes mais do que uma com margem de 2,5 pontos. Com o piso, a vantagem cai para cerca de 8 vezes. Assim, amostras enormes continuam valendo mais, mas não a ponto de engolir todas as outras.
3. Quando um instituto divulga uma nova pesquisa, ela substitui a anterior, em vez de se somar a ela. Se não fosse assim, institutos que publicam com mais frequência teriam mais influência no modelo só por publicarem mais e duas medições feitas com o mesmo método seriam tratadas como evidências independentes, quando não são.
4. Como explicado anteriormente, todas as pesquisas são convertidas para votos válidos antes de entrar na média.
T – A transferência de votos (25%)
Este componente parte do resultado do primeiro turno e pergunta como os eleitores de Cury, Renan e Caiado se redistribuem entre os dois finalistas. Para isso, usa os cruzamentos divulgados por cinco institutos, que perguntaram aos eleitores de cada candidato derrotado em quem votarão agora. É o componente mais “estrutural” do modelo, porque se apoia no voto observado e não apenas em intenções.
E – O modelo expandido (15%)
Este componente toma a transferência como base e acrescenta outro grupo, quem se absteve, votou branco ou nulo no primeiro turno e pode voltar às urnas no segundo. As pesquisas indicam que esse grupo tem preferências diferentes das do eleitorado que votou de maneira válida. Ignorá-lo seria supor que o eleitorado do segundo turno é idêntico ao do primeiro.
R – A tendência recente (10%)
O último componente ajusta uma linha de tendência às pesquisas mais recentes para captar se há um movimento consistente em alguma direção. É o componente mais volátil. Ao longo da construção do modelo, ele mudou de direção várias vezes conforme chegavam pesquisas novas (uma única pesquisa chegou a empurrá-lo para o empate antes de as seguintes o trazerem de volta). Por isso recebe o menor peso.
Por que esses pesos?
Os pesos 50/25/15/10 são escolhas de modelagem, não coeficientes estimados estatisticamente, prefiro deixar isso claro desde já. A lógica por trás deles é a seguinte:
- O agregador de pesquisas recebe metade do peso porque mede diretamente a disputa que interessa, o segundo turno, entre esses dois candidatos.
- A transferência e o modelo expandido somam 40% porque trazem estrutura comportamental ancorada no primeiro turno. Funcionam como um contrapeso às pesquisas, apoiado em outro tipo de evidência.
- A tendência recebe só 10% porque movimentos de curto prazo podem ser ruído amostral.
Há um detalhe que um(a) leitor(a) atento(a) vai notar, os quatro componentes não são totalmente independentes. O modelo expandido é construído sobre a transferência e a tendência usa as mesmas pesquisas do agregado. Na prática, portanto, o modelo combina duas grandes fontes de evidência, as pesquisas de segundo turno, com cerca de 60% do peso, e o comportamento ancorado no primeiro turno, com cerca de 40%. A divisão em quatro componentes serve para separar perguntas diferentes e apenas isso (não são quatro fontes independentes).
Outros pesos razoáveis levariam a números ligeiramente diferentes. Mas, como os quatro componentes hoje apontam para uma faixa estreita, todos entre 50,5% e 51,5% para o mesmo candidato, mudanças moderadas nos pesos alteram o resultado final em poucos décimos de ponto. Essa robustez é uma das conclusões do exercício.
O modelo não nasceu pronto, evoluiu à medida que novas informações apareciam:
- Primeira versão: uma redistribuição hipotética dos votos dos candidatos derrotados (70% para um lado, 30% para o outro), útil apenas como exercício de sensibilidade.
- Âncora do primeiro turno: com o resultado oficial, o modelo passou a partir do voto real e não mais de pesquisas pré-eleitorais.
- Primeiros dados de transferência: um cruzamento do Datafolha substituiu a divisão arbitrária de 70/30.
- Transferência por candidato: a Quaest passou a separar os eleitores de Cury, Renan e Caiado, revelando que eles se comportam de forma bem diferente.
- Quem não votou: a mesma Quaest mediu as preferências de quem se absteve ou votou branco ou nulo, dando origem ao modelo expandido.
- Agregação de pesquisas: em vez de comparar pesquisas isoladas, o modelo passou a ponderá-las por recência e precisão.
- Conjunto de transferências: como os institutos discordavam muito entre si sobre a migração de votos, a transferência deixou de depender de uma única fonte e passou a combinar cinco.
- Teste de sensibilidade: por fim, acrescentei uma camada separada para testar o efeito de um possível erro comum a todas as pesquisas.
Cada etapa corrigiu uma fraqueza da anterior. Por isso, o modelo continua aberto, quando chega uma pesquisa nova, só a camada correspondente é recalculada.
Para onde vão os votos de Cury, Renan e Caiado
Cerca de 7,8% dos votos válidos do primeiro turno foram para candidatos que ficaram pelo caminho. A primeira versão do modelo supunha, de forma puramente hipotética, que 70% desses votos iriam para um finalista e 30% para o outro. Assim que as pesquisas passaram a perguntar a esses eleitores em quem votarão agora, a suposição foi substituída por dados.
| Instituto | Cury → F | Cury → L | Renan → F | Renan → L | Caiado → F | Caiado → L |
| Quaest (14/10) | 30% | 34% | 40% | 14% | 42% | 23% |
| Palver | 32% | 64% | 41% | 41% | 61% | 35% |
| PoderData | 47% | 36% | 46% | 24% | 50% | 30% |
| Ipespe/Abrapel | 50% | 31% | 40% | 20% | 59% | 18% |
| Datafolha* | 46% | 27% | — | — | — | — |
F = Flávio; L = Lula. O restante corresponde a brancos, nulos e indecisos. *O Datafolha divulgou apenas o bloco dos três candidatos somados.
A tabela mostra que não existe um “eleitor de terceira via” genérico. Os eleitores de Caiado migram com clareza para Flávio em todos os institutos. Os de Renan também pendem para ele, mas com uma fatia grande de brancos e nulos, que chega a 32% no Ipespe. Os de Cury são o caso mais instável, a Palver e a Quaest mostram Lula à frente, enquanto o PoderData e o Ipespe mostram Flávio.
Parte dessa divergência tem explicação estatística, os eleitores de cada candidato derrotado são uma fração pequena da amostra e a margem de erro nesses subgrupos é muito maior do que a da pesquisa como um todo. Por isso, escolher um único instituto seria arriscado, assim o modelo combina os cinco em um conjunto de transferências, no qual nenhuma fonte domina. O resultado dessa camada é: Flávio 51,51% | Lula 48,49%.
Quem não votou no primeiro turno
O eleitorado do segundo turno não é uma cópia do primeiro. Segundo o TSE, cerca de 33 milhões de eleitores (21,08%) se abstiveram no primeiro turno e outros 5,9 milhões votaram branco (1,84%) ou nulo (2,93%). Uma parte dessas pessoas pode votar agora e outra parte de quem votou pode ficar em casa.
O que importa é que esse grupo não pensa como a média. Na Quaest de 14 de outubro, entre quem se absteve ou votou branco ou nulo no primeiro turno, 43% declararam voto em Lula e 38% em Flávio, e 17% disseram que vão votar branco, nulo ou não votar. A rodada de 21 de outubro mostrou um quadro parecido, 40% a 36%, com 21% fora do voto válido.
O modelo expandido parte da camada de transferência e acrescenta o retorno de parte desse grupo, de forma conservadora. Dizer a um pesquisador que vai votar não é o mesmo que ir à urna, então o modelo não supõe que todos voltem. Como esse eleitorado pende levemente para Lula, o efeito é estreitar a diferença: Flávio 50,52% | Lula 49,48%.
A rodada do Datafolha de 22 de outubro traz um indício na mesma direção, entre os entrevistados que dizem ter votado no primeiro turno, Flávio tem 51% dos votos válidos, contra 50% na amostra total. O instituto não divulga um cruzamento específico para quem se absteve, mas o padrão é coerente com a ideia de que o retorno desse grupo estreita a disputa.
O resultado atual
Combinando os quatro componentes com seus pesos, a estimativa central do modelo, atualizada em 24 de outubro, é: Flávio 51,06% | Lula 48,94% (votos válidos).
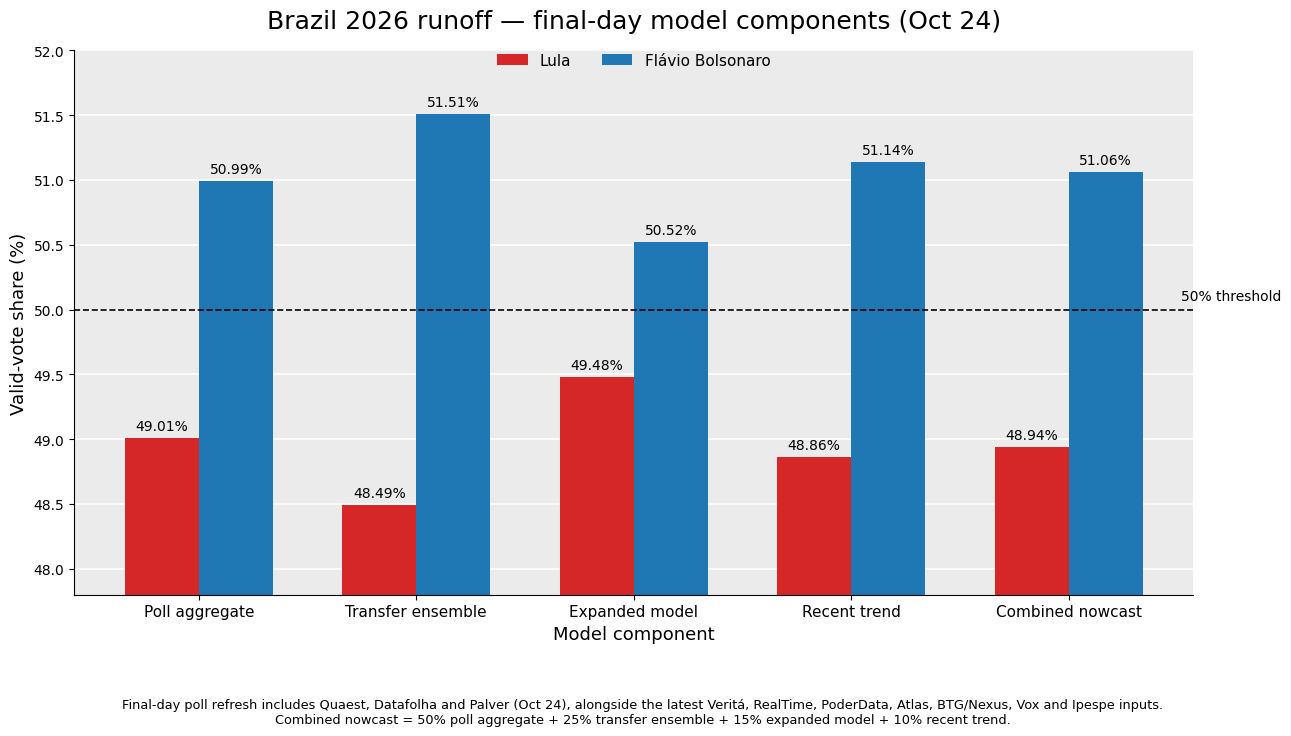
Figura 1: Componentes do modelo e estimativa combinada, em votos válidos. A linha tracejada marca 50%. (Gráfico em inglês: “Poll aggregate” = agregado de pesquisas; “Transfer ensemble” = transferência; “Expanded model” = modelo expandido; “Recent trend” = tendência; “Combined nowcast” = estimativa combinada.)
Os quatro componentes apontam para o mesmo lado e para uma faixa estreita, entre 50,5% e 51,5%. Isso torna o resultado pouco sensível aos pesos escolhidos.
Em 22 de outubro, duas pesquisas puxaram o modelo em direção ao empate. O PoderData (51% a 49%) substituiu sua rodada anterior (52% a 48%) e, à noite, o Datafolha mostrou 50% a 50%, contra 51% a 49% na rodada anterior. Com isso, a estimativa caiu para 50,88%. Em 23 de outubro, o movimento se inverteu. A Veritá divulgou 51,3% a 48,7%, substituindo sua leitura anterior de 50,7% a 49,3% e a RealTime Big Data mostrou 52% a 48%. Como são observações recentes, as duas têm peso alto: o agregado de pesquisas subiu de 50,73% para 50,88% e a tendência de 50,62% para 51,20%. A estimativa combinada voltou a 51,02%, praticamente onde estava antes do Datafolha. As camadas de transferência e de quem não votou continuam inalteradas. Esse vaivém ilustra por que a tendência recebe só 10% do peso, em dois dias, ela oscilou mais de meio ponto. Já a estimativa combinada se moveu, no total, pouco mais de um décimo. A Veritá é um bom exemplo do piso metodológico em ação, com 15.554 entrevistas e margem de ±1 ponto, ela pesaria cerca de 4 vezes mais que a RealTime (2.000 entrevistas, ±2 pontos) se apenas a margem de erro contasse. Com o piso de 0,75 ponto, essa vantagem cai para cerca de 2,9 vezes.
Em 24 de outubro, véspera da votação, saíram as últimas pesquisas. Quaest e Datafolha mostraram o mesmo resultado, 51% a 49% dos votos válidos, e cada uma substituiu sua rodada anterior no modelo. A Palver foi na direção oposta, manteve Flávio em 50% do voto total e subiu Lula de 48% para 49%, com 1% de brancos e nulos. Em votos válidos, isso significa passar de cerca de 51,0% a 49,0% na rodada de 21 de outubro para 50,5% a 49,5% agora. O agregado de pesquisas subiu de 50,88% para 50,99%, porque as novas leituras de Quaest e Datafolha são mais favoráveis a Flávio do que suas rodadas anteriores. Já a tendência recuou levemente, de 51,20% para 51,14%, de forma que as novas pesquisas, sobretudo a Palver, ficaram um pouco abaixo de algumas das anteriores, como a RealTime (52% a 48%), e isso achatou a inclinação de curto prazo. O nível subiu e a inclinação diminuiu, a estimativa final ficou em 51,06%, apenas quatro centésimos acima da versão anterior. As pesquisas finais reforçam o centro em torno de 51 a 49, em vez de deslocá-lo. Ao longo de três dias e seis pesquisas novas, a estimativa central oscilou entre 50,88% e 51,06%, menos de dois décimos de ponto.
Por que 51 a 49 não é certeza?
Uma estimativa central sozinha engana em uma disputa tão apertada. Para medir a incerteza, o modelo usa simulação de Monte Carlo, recalcula o resultado milhares de vezes, sorteando variações plausíveis em cada componente e acrescentando um erro comum a todos. O resultado é uma faixa de valores, e não um número único.
| Estimativa central (Flávio) | Faixa de 80% | Faixa de 95% | |
| Cenário neutro | 51,06% | 50,07% – 52,06% | 49,54% – 52,57% |
Na versão final, o limite inferior da faixa de 80% está em 50,07%, acima da linha de 50%, mas por pouco. Ao longo das atualizações, esse limite oscilou entre 49,89% e 50,07%, sempre colado nos 50%. Já a faixa de 95% cruzou os 50% em todas as versões do modelo e na final vai de 49,54% a 52,57%. Em outras palavras, o modelo aponta uma vantagem pequena, mas um resultado favorável a Lula continua dentro do que é plausível.
E se as pesquisas errarem todas na mesma direção?
Nas últimas semanas, dois especialistas do setor levantaram publicamente essa hipótese, são eles um ex-dirigente de um dos maiores institutos de pesquisa do país e um executivo de um instituto internacional. Os argumentos foram de que parte do eleitorado de direita pode estar sub-representada, seja por recusar entrevistas, por morar em áreas de difícil acesso aos pesquisadores ou por limitações nos cadastros telefônicos, e de que erros de pesquisa tendem a ser correlacionados entre institutos e não de maneira independente.
O modelo não assume que isso seja verdade. Em vez disso, testa quanto o resultado mudaria se fosse. Supõe-se um viés comum de b pontos. Ele é aplicado integralmente ao agregado de pesquisas e à tendência, e pela metade às camadas de transferência e expandida, que já estão parcialmente ancoradas no voto real do primeiro turno. No resultado final, cada ponto de viés se traduz em 0,8 ponto de deslocamento.
| Cenário | Flávio | Lula | 80% | 95% |
|---|---|---|---|---|
| Neutro | 51,06% | 48,94% | 50,07 – 52,06 | 49,54 – 52,57 |
| Leve (+0,75) | 51,66% | 48,34% | 50,67 – 52,66 | 50,14 – 53,17 |
| Forte (+1,50) | 52,26% | 47,74% | 51,27 – 53,26 | 50,75 – 53,78 |
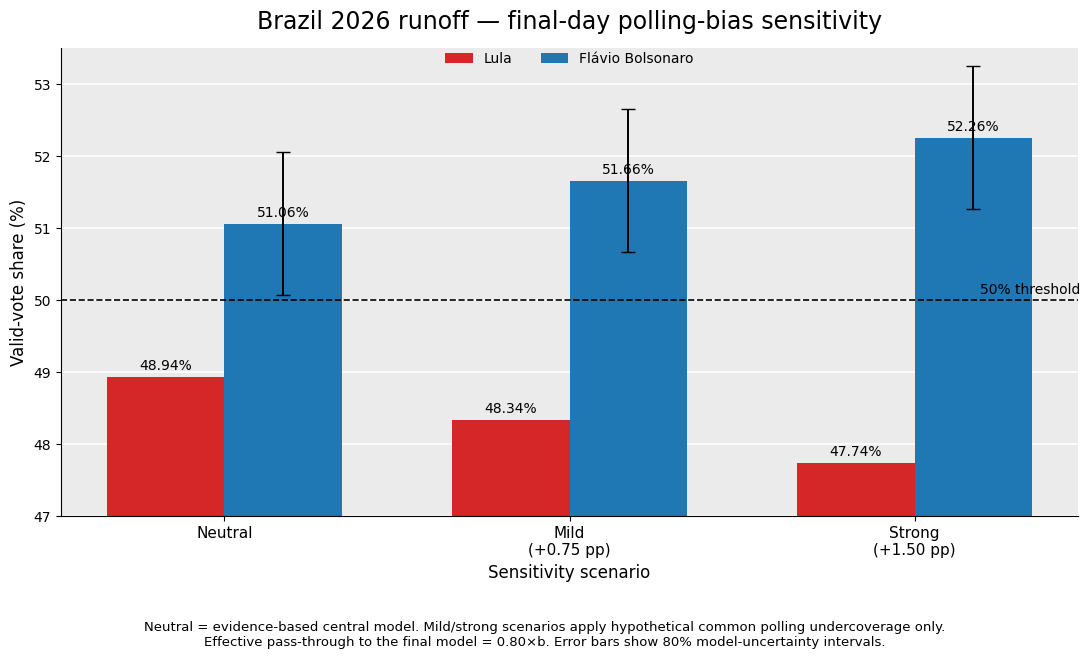
Figura 2: Legenda sugerida: Estimativa central em cada cenário de viés hipotético. As barras de erro mostram as faixas de 80%. (Gráfico em inglês: “Neutral” = neutro; “Mild” = leve; “Strong” = forte.)
É preciso cuidado na leitura. Nos dois cenários com viés, as faixas de 95% ficam inteiramente acima de 50%, mas no cenário leve por muito pouco (50,14%). Vale relembrar que isso só é válido se o suposto viés realmente existir, embora não haja evidência medida de que exista, nem de qual seria seu tamanho. Este é um teste de robustez e não deve ser visto como uma correção das pesquisas. O teste também olha em uma única direção porque foi essa a hipótese levantada. Um erro no sentido oposto deslocaria o resultado na mesma proporção, a favor de Lula.
Como todo modelo, este tem limites que convém deixar claros. Os pesos de cada componente são escolhas de modelagem e não coeficientes estimados a partir do desempenho em eleições passadas. Os cruzamentos de transferência se apoiam em subamostras pequenas e variam bastante entre institutos e entre rodadas. O modelo também não estima o viés próprio de cada instituto, o piso metodológico limita a influência de qualquer pesquisa isolada, mas não identifica tendências sistemáticas. O comparecimento é outro ponto difícil de prever, já que dizer que vai votar não garante o voto. Fatos de última hora, como debates, denúncias, mobilização ou abstenção estratégica, ficam fora do modelo e os cenários de viés são hipotéticos, sem medir um erro real. Por fim, o modelo não calcula a probabilidade de vitória de nenhum candidato. Para isso, seria preciso calibrá-lo com o histórico de erros de eleições anteriores.
O valor deste exercício não está na segunda casa decimal, mas na disciplina de separar o que é evidência (pesquisas, voto do primeiro turno, migração medida), o que é premissa (pesos, comparecimento) e o que é teste de sensibilidade (o viés hipotético). Hoje, a evidência aponta para uma disputa muito próxima de 51 a 49, com uma incerteza grande o bastante para que qualquer resultado entre os dois candidatos seja plausível.
Referências
- Folha de S.Paulo (5/10/2026). Resultado do 1º turno. https://www1.folha.uol.com.br/internacional/en/brazil/2026/10/gap-between-flavio-and-lula-is-smallest-ever-in-first-round-of-presidential-election.shtml
- UOL (17/10/2026). Para onde vão os votos de Cury, Renan e Caiado, segundo 4 pesquisas. https://noticias.uol.com.br/eleicoes/2026/10/17/pesquisas-destino-votos-cury-renan-caiado.ghtm
- UOL (14/10/2026). Quaest: segundo turno e transferência de votos. https://noticias.uol.com.br/eleicoes/2026/10/14/quaest-presidencial-intencao-de-voto-segundo-turno.ghtm
- Brazil Journal (16/10/2026). O ex-chefe do Ibope diz o que enxerga – e que as pesquisas não mostram. https://braziljournal.com/o-ex-chefe-do-ibope-diz-o-que-enxerga-e-que-as-pesquisas-nao-mostram
- UOL/Agência Estado (21/10/2026). Quaest: entre ausentes, brancos e nulos no 1º turno, 40% votam em Lula e 36% em Flávio. https://noticias.uol.com.br/ultimas-noticias/agencia-estado/2026/10/21/quaest-entre-ausentesbrancosnulos-no-1-turno-40-votam-em-lula-e-36-em-flavio.htm
- Brazil Journal (22/10/2026). “Mal-estar” favorece a direita, diz chefe da Ipsos: “O sistema não está funcionando”. https://braziljournal.com/mal-estar-favorece-a-direita-diz-chefe-da-ipsos-o-sistema-nao-esta-funcionando
- Seu Dinheiro (17/10/2026). Pesquisa Ipespe. https://www.seudinheiro.com/2026/politica/pesquisa-ipespe-lula-ganha-terreno-e-diferenca-para-flavio-bolsonaro-cai-tres-pontos-mlim/
- Folha de S.Paulo (16/10/2026). Datafolha: 51% a 49% dos votos válidos. https://www1.folha.uol.com.br/internacional/en/brazil/2026/10/datafolha-flavio-bolsonaro-has-51-and-lula-49-of-valid-votes-a-technical-tie.shtml
- UOL (21/10/2026). Pesquisa Palver: segundo turno presidencial, 21 de outubro. https://noticias.uol.com.br/eleicoes/2026/10/21/palver-pesquisa-presidencial-segundo-turno-21-de-outubro.ghtm
- Poder360 (22/10/2026). PoderData/Aya. https://www.poder360.com.br/poderdata/flavio-tem-51-e-lula-tem-49-dos-votos-validos-diz-poderdata-aya/
- UOL (22/10/2026). Pesquisas de segundo turno por instituto. https://noticias.uol.com.br/eleicoes/2026/10/22/pesquisa-segundo-turno-presidente-2026-veja-os-numeros-de-cada-instituto.ghtm
- Folha de S.Paulo (22/10/2026). Datafolha: Flávio Bolsonaro e Lula empatam com 50% dos votos válidos cada. https://www1.folha.uol.com.br/poder/2026/10/datafolha-flavio-bolsonaro-e-lula-empatam-com-50-dos-votos-validos-cada.shtml
- NC News (23/10/2026). Veritá: Flávio Bolsonaro tem 51,3% e Lula 48,7% dos votos válidos no 2º turno. https://ncnews.com.br/2026/10/23/verita-flavio-bolsonaro-lula-2-turno/
- UOL (23/10/2026). RealTime Big Data: Flávio tem 52% e Lula 48% dos votos válidos. https://noticias.uol.com.br/eleicoes/2026/10/23/realtime-big-data-flavio-tem-52-e-lula-48-dos-votos-validos.ghtm
- Folha de S.Paulo (24/10/2026). Datafolha: Flávio Bolsonaro tem 51% dos votos válidos e Lula 49%, em empate técnico. https://www1.folha.uol.com.br/poder/2026/10/datafolha-flavio-bolsonaro-tem-51-dos-votos-validos-e-lula-49-em-empate-tecnico.shtml
- UOL (24/10/2026). Quaest: segundo turno presidencial, 24 de outubro. https://noticias.uol.com.br/eleicoes/2026/10/24/quaest-presidencial-segundo-turno-24-de-outubro.ghtm
- UOL (24/10/2026). Pesquisa Palver no 2º turno presidencial. https://noticias.uol.com.br/eleicoes/2026/10/24/pesquisa-palver-no-2-turno-presidencial-veja-numeros-divulgados-hoje.ghtm
The degree of knowledge gain metric: Evaluating how searchers acquire new information while searching online
setembro 24, 2026 § Deixe um comentário
Tibau, M., Siqueira, S. W. M., Nunes, B. P., & Vakkari, P. (2026). The degree of knowledge gain metric: Evaluating how searchers acquire new information while searching online. Journal of Information Science, 0(0). https://doi.org/10.1177/01655515261478899
Abstract: This study presents the degree of knowledge gain, a behavioral metric that estimates how much searchers learn during Web searches. Grounded in information theory and Shannon entropy, the metric quantifies reductions in uncertainty by analyzing query reformulations, clicks, and document positions, avoiding reliance on pre/post-testing or self-reports. The metric was validated with a cohort of legal professionals who completed three domain-specific search tasks on a national legal platform. Behavioral coding of think-aloud sessions and statistical tests (analysis of variance; Spearman rank correlation) demonstrated strong positive correlations between the degree of knowledge gain and conventional transfer of learning scores, with structured tasks producing the highest gains. This approach offers an automated, scalable indicator of learning, enriching the Searching as Learning paradigm and enabling real-time adaptation in personalized search, intelligent tutoring, and conversational systems.
Evaluating Knowledge Gain in Search Environments: An Exploratory Study of Learning Measurement
maio 20, 2026 § 2 Comentários
- Marcelo Tibau UNIRIO
- Rafael Tavares da Silva UNIRIO
- Sean Wolfgand Matsui Siqueira UNIRIO
- Bernardo Pereira Nunes Australian National University
DOI: https://doi.org/10.5753/sbsi.2026.248557
Resumo
Research Context: Searching as Learning (SaL) frames web search as a process where users construct and refine knowledge. However, measuring knowledge gain in natural search environments remains a methodological challenge. Scientific and/or Practical Problem: Traditional behavioral proxies (e.g., dwell time, clicks) scale well but fail to capture conceptual change, while pre/post-tests provide richer insights but are intrusive. This gap limits the development of search systems that can evaluate and promote learning. Proposed Solution and/or Analysis: This study advances a computational measure based on entropy reduction and semantic similarity, and novelly operationalizes it through a browser plug-in that enables real-time measurement in natural search environments, extending prior formalizations and prototype-based validations of the DKG metric. Related IS Theory: The study draws on Shannon’s Information Theory and Information Processing Theory in IS to conceptualize knowledge gain as uncertainty reduction supported by socio-technical processes. Research Method: An experiment combined three structured search tasks, pre/post-tests, and Concurrent Think-Aloud protocols. Quantitative measures (Transfer of Learning scores, also known as ToL, and values from the proposed metric) were triangulated with qualitative coding using OISS and ESKiP frameworks. Summary of Results: Statistical analysis showed a moderate positive correlation between ToL and the proposed metric (r = 0.62, p < 0.01). Bland–Altman analysis revealed systematic differences in scale, with ToL showing higher values, yet relative patterns were consistent. Transcripts emphasized how strategies such as query specialization, evaluation of sources, and persistence in reformulation aligned with higher values. Contributions and Impact to IS area: The study contributes a validated computational metric and artifacts for measuring knowledge gain in real search environments. It reinforces the sociotechnical view of IS by linking human strategies, processes, and technological advantages, and points to adaptive search systems that could measure and promote learning.
TIBAU, Marcelo; SILVA, Rafael Tavares da; SIQUEIRA, Sean Wolfgand Matsui; NUNES, Bernardo Pereira. Evaluating Knowledge Gain in Search Environments: An Exploratory Study of Learning Measurement. In: SIMPÓSIO BRASILEIRO DE SISTEMAS DE INFORMAÇÃO (SBSI), 22. , 2026, Vitória/ES. Anais […]. Porto Alegre: Sociedade Brasileira de Computação, 2026 . p. 478-496. ISSN 3086-4836. DOI: https://doi.org/10.5753/sbsi.2026.248557.
Implementing Knowledge Gain Measurement in Real Search Environments
maio 20, 2026 § Deixe um comentário
- Rafael Tavares da Silva UNIRIO
- Sean Wolfgand Matsui Siqueira UNIRIO
- Marcelo Tibau UNIRIO
DOI: https://doi.org/10.5753/sbsi_estendido.2026.249057
Resumo
The operationalization of learning metrics in real search environments remains an open challenge in the Searching as Learning (SaL) paradigm. While behavioral proxies offer scalability, they capture conceptual change only indirectly; structured assessments provide more direct evidence but often compromise ecological validity. The Degree of Knowledge Gain (DKG) metric addresses this tension by combining Shannon entropy with semantic similarity between queries and clicked documents to model the progressive reduction of uncertainty during search. This paper reports on two technological artifacts developed to embed DKG computation into real-world search workflows, within the scope of the CNPq project 3C-BPA: Comportamento de busca, Complexidade da informação e pensamento Crítico na Busca como um Processo de Aprendizagem. A standalone search engine prototype established the feasibility of real-time DKG computation but exposed limitations in ecological validity and operational sustainability. These were addressed by a Chrome browser extension that estimates the metric unobtrusively while users interact with their preferred search engines. To assess the extension’s applicability, an experiment was conducted combining preand post-tests with the Concurrent Think-Aloud (CTA) protocol and automated interaction logging. Preliminary results indicate that DKG is sensitive to variation in search strategy use as participants who engaged in systematic query reformulation and multi-source evaluation achieved stronger knowledge gains, while those exhibiting disorientation and limited cognitive regulation showed more modest outcomes. Beyond its empirical contributions, the study illustrates how undergraduate research participation can play a substantive role in advancing the development and application of formal learning metrics in information science.
SILVA, Rafael Tavares da; SIQUEIRA, Sean Wolfgand Matsui; TIBAU, Marcelo. Implementing Knowledge Gain Measurement in Real Search Environments. In: CONCURSO DE TESES, DISSERTAÇÕES E TCCS EM SI – IC/IT – SIMPÓSIO BRASILEIRO DE SISTEMAS DE INFORMAÇÃO (SBSI), 22. , 2026, Vitória/ES. Anais […]. Porto Alegre: Sociedade Brasileira de Computação, 2026 . p. 61-70. DOI: https://doi.org/10.5753/sbsi_estendido.2026.249057.
Quando o saber deixa de ser humano e nasce a Epistemologia do Chatbot
dezembro 11, 2025 § Deixe um comentário
Ninguém nota quando a água começa a ferver. O sapo, tranquilo, continua imóvel na panela enquanto a temperatura sobe devagar, agradável, até demais. Só quando já é tarde, o nosso amigo anfíbio percebe que perdeu a chance de saltar e se salvar. Nossa relação com as Inteligências Artificiais (IAs), em especial com os chatbots, segue o mesmo padrão. As mudanças são sutis, uma resposta que parece mais segura ali, um tom mais empático ou um conselho mais convincente aqui. De forma quase imperceptível, a água esquenta. O que antes era apenas uma ferramenta começa a ocupar o espaço de uma autoridade e o salto epistêmico que separa informação de conhecimento se dissolve na temperatura morna da conveniência.
A filósofa Susan Schneider chama isso de “problema do sapo cozido” (Schneider, 2025), caracterizado pela combinação de fatores como confiança excessiva, opacidade dos modelos, manipulação emocional e perda gradual de autonomia epistêmica, criando um cenário em que a dependência dos chatbots cresce sem que percebamos (Figura 1).

Figura 1: O “problema do sapo cozido” na era dos chatbots, em que a confiança crescente transforma ferramentas em autoridades epistêmicas.
Leia o texto completo na Revista Horizontes da SBC (Sociedade Brasileira de Computação).
The Great AI Paradox of 2025
novembro 28, 2025 § Deixe um comentário
Why Enterprise Adoption Is High, Impact Is Low, and What High Performers Reveal About the Future
Three years after generative AI shattered the popular imagination and reshaped the technological agenda of entire industries, 2025 should have been the year when enterprises finally reaped the gains promised by the AI revolution. And in some ways, it is. The new McKinsey report The State of AI in 2025 (access it here) reveals that 88 percent of companies claim to be using AI in at least one business function (p. 4). This is an unprecedented level of penetration, a sign that organizations have crossed the psychological threshold from curiosity to action.
Yet beneath this impressive adoption curve lies a more sobering truth: AI may be everywhere, but its impact is still shallow. Nearly two-thirds of organizations remain stuck in experimentation or pilots, unable to scale their AI efforts to the enterprise level (see Exhibit 1, p. 4). And only 39 percent attribute any EBIT impact to AI, usually less than 5 percent (p. 11).
A Epistemologia do Chatbot – Video
novembro 21, 2025 § Deixe um comentário
Como podemos confiar no conhecimento gerado por sistemas de IA? Nesse vídeo, exploramos os limites epistêmicos dos modelos de linguagem, discutindo temas como reliabilismo e internalismo, mudanças contínuas em modelos (problema da justificação diacrônica), privacidade e confiança, e o debate sobre a possível senciência das máquinas. A partir da metáfora do “sapo cozido”, refletimos sobre como mudanças graduais nas interações com chatbots podem reduzir nossa autonomia intelectual, minando o pensamento crítico e a capacidade de avaliar a procedência das informações. O vídeo propõe uma leitura filosófica e crítica sobre o papel da epistemologia na era dos chatbots, uma discussão essencial para quem se interessa por IA, ética, filosofia da mente e política da tecnologia. Assista, reflita e questione: o que realmente significa saber, quando quem responde é uma máquina?
ChatGPT for chatting and searching: Repurposing search behavior – Video
novembro 14, 2025 § Deixe um comentário
No vídeo exploramos o que significa Chat and Search, a fusão entre busca de informação e diálogo. Se antes você digitava palavras-chave e examinava listas de resultados, agora você pode conversar com sistemas de IA e construir conhecimento em múltiplos turnos de prompt, resposta, avaliação e refinamento. Convidamos você a descobrir como esse processo redefine o papel do sistema de busca: de provedor de respostas para parceiro cognitivo. Veremos também as quatro grandes linhas de pesquisa que emergem desse paradigma (cognição, design, epistemologia e futuros sociotécnicos) e como elas convergem em zonas de investigação onde podemos projetar novas interfaces, métricas de aprendizagem e políticas informacionais.

